国产AI芯片详解的突围之路
2026-11-19
浏览量:次
### 国产AI芯片的突围之路:从制程追赶转向架构突围
在全球人工智能算力竞赛进入白热化的当下,国产AI芯片正站在一个关键的十字路口。面对外部供应链的持续收紧与制程工艺的物理瓶颈,中国芯片产业正在经历一场深刻的战略转型:从单纯追求先进制程的“单点突破”,转向以系统级架构创新为核心的“换道超车”。这不仅是技术路线的修正,更是一场关于生存与发展的突围战。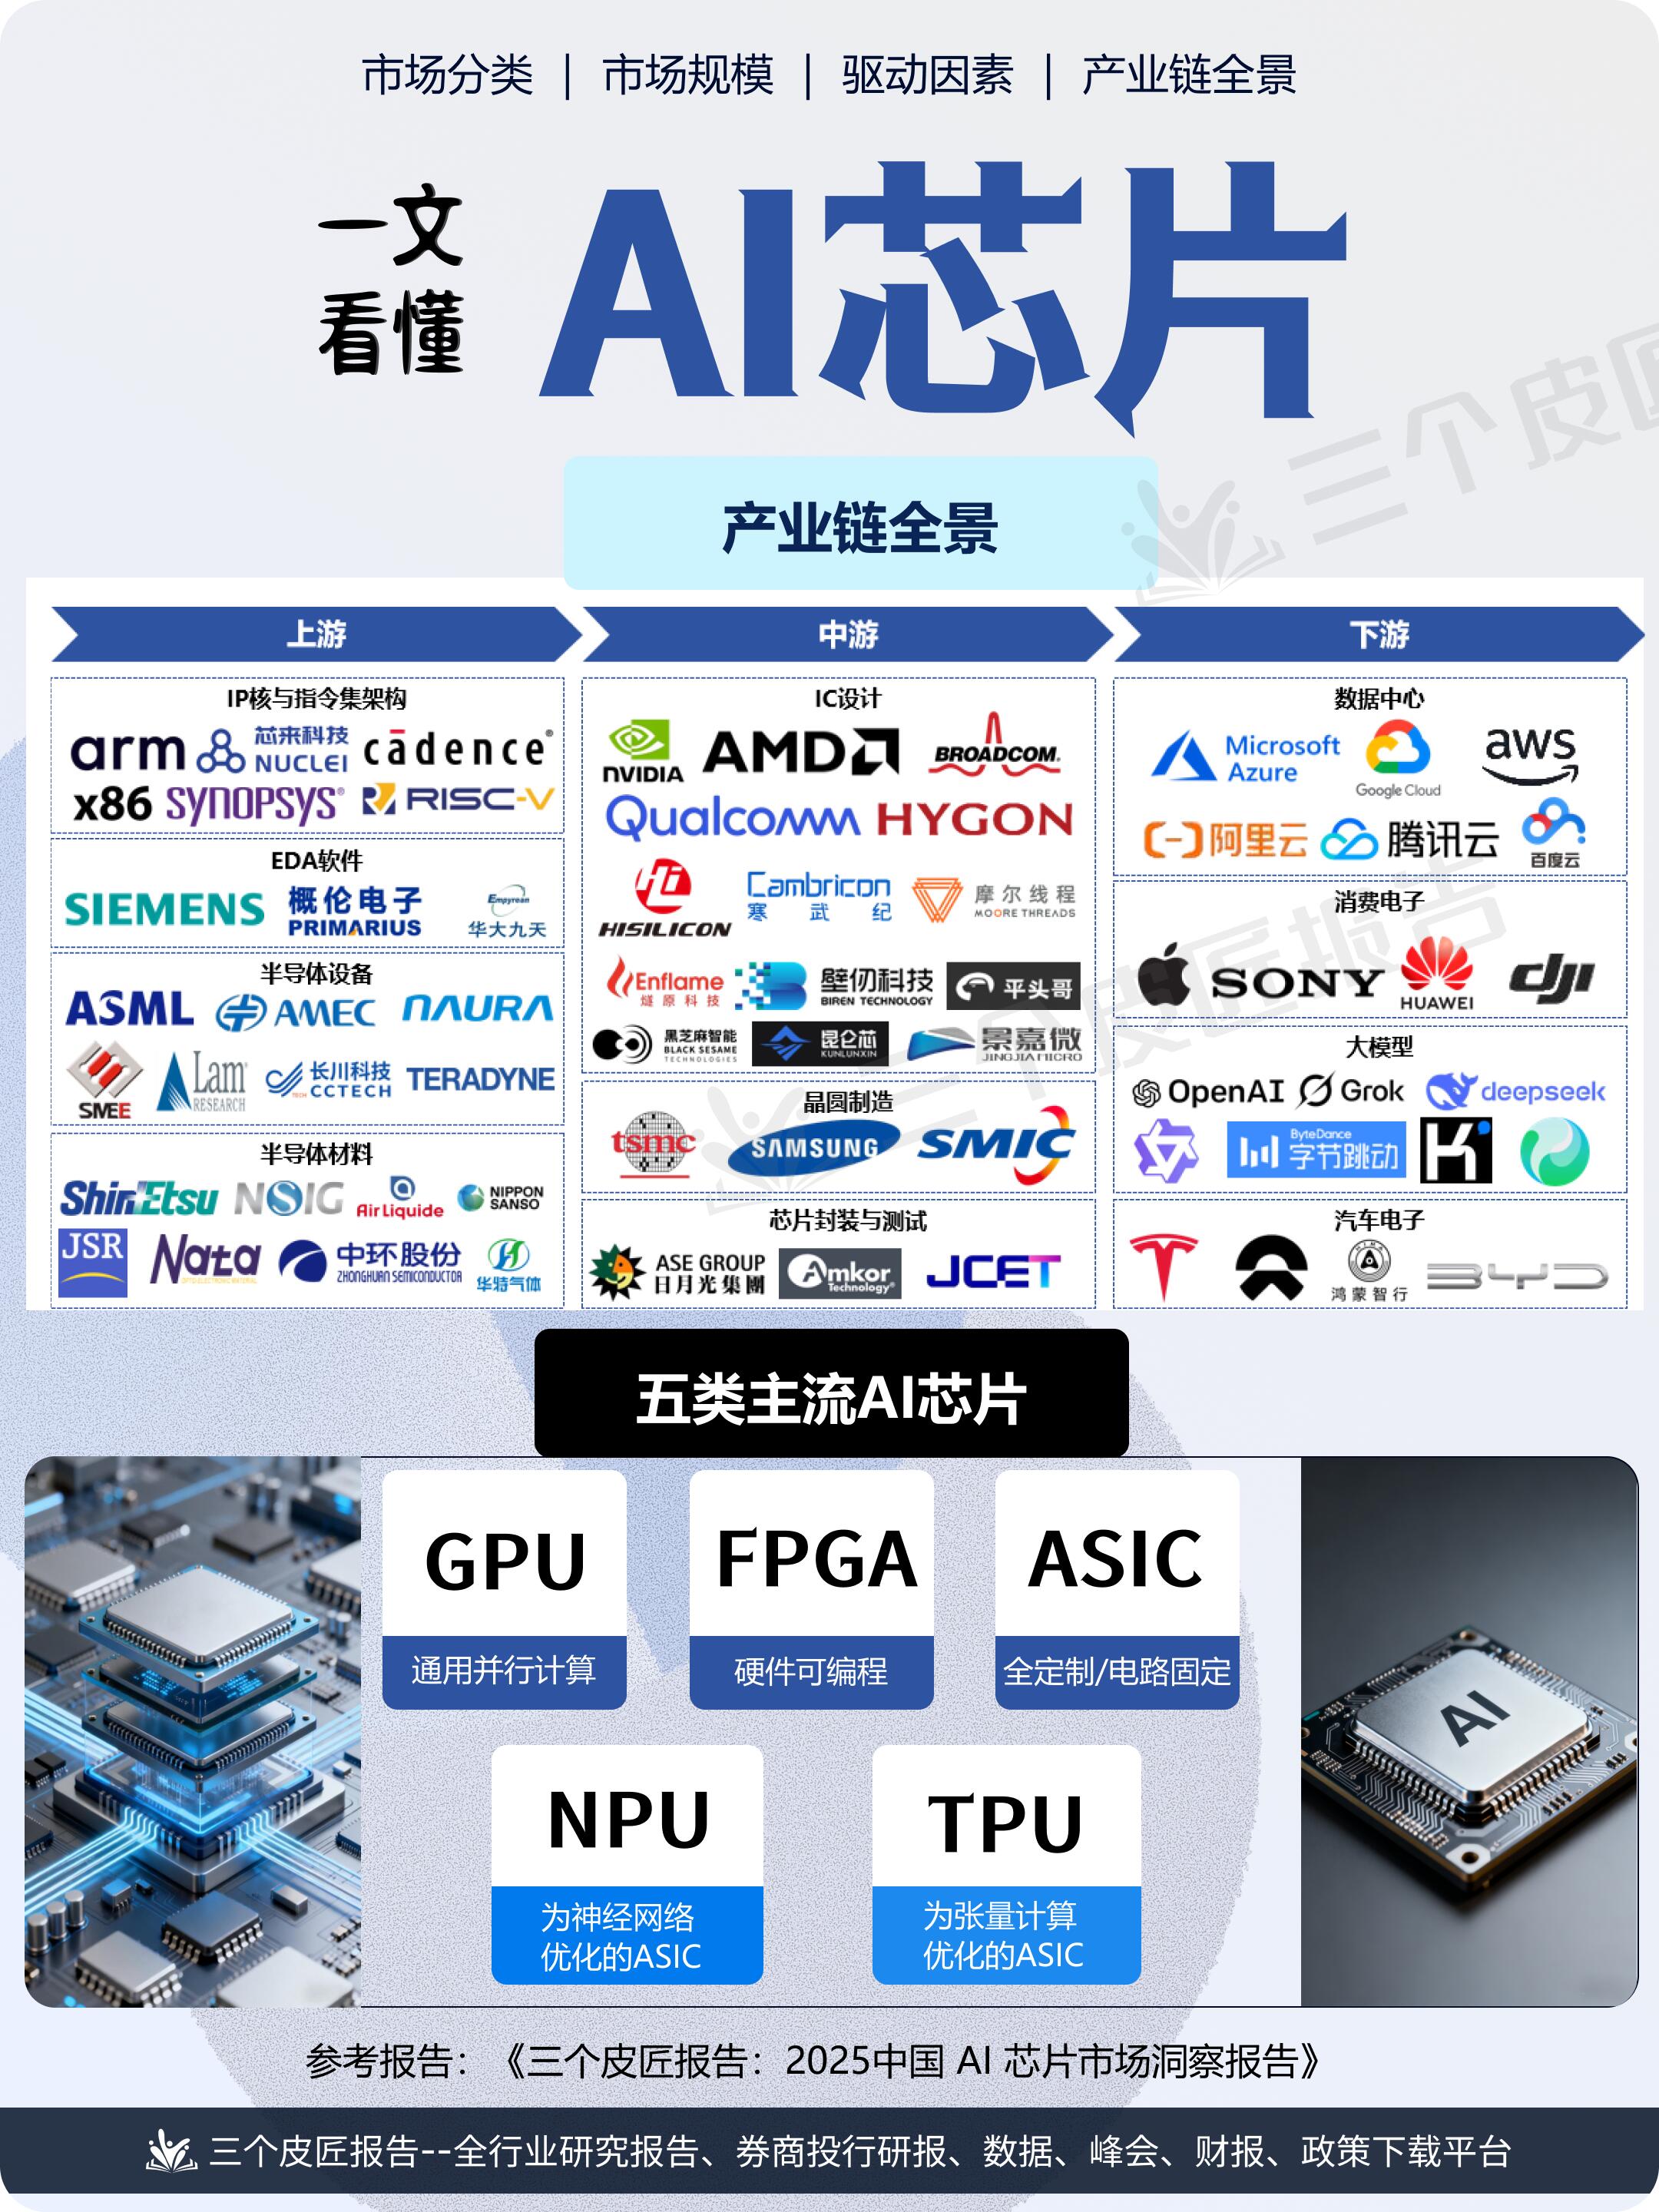
#### 一、制程之困:单芯片算力的物理天花板
在AI算力的传统评价体系中,制程工艺往往被视为核心指标。然而,当前的现实是残酷的。主流国际厂商已迈向3nm甚至2nm工艺,晶体管密度突破300 MTr/mm²,而国内主流方案仍主要停留在7nm阶段。这种代差直接导致了单芯片性能的悬殊——在BF16精度下,旗舰GPU算力可达2500 TFLOPS,而7nm国产芯片往往在800 TFLOPS左右徘徊,且面临着散热与能效比的严峻挑战。
但这并非绝路。随着摩尔定律放缓,单纯依赖制程微缩带来的红利正在边际递减。国产厂商逐渐意识到,在无法获取最先进光刻设备的情况下,死磕单芯片制程无异于以己之短攻彼之长。真正的突围,在于跳出“唯制程论”的陷阱,寻找新的算力增长极。
#### 二、架构突围:以“超节点”重构算力边界
面对单卡算力的差距,系统级架构创新成为了破局的关键。国产AI芯片正在通过“超节点”架构,将数十乃至数百颗芯片通过高速互联技术捆绑,构建逻辑上的“巨型单机”。
这一路径的核心在于“化整为零,聚沙成塔”。通过引入Chiplet(芯粒)技术和定制化互联协议,国产厂商利用3D封装与硅互连桥技术,将多颗7nm芯片垂直堆叠或平面拼接。配合800G光模块直连与Fat-Tree拓扑优化,芯片间的通信延迟被压缩至纳秒级。这意味着,虽然单颗国产芯片的算力可能只有国际顶尖水平的三分之一,但通过万卡级集群的线性加速比,完全可以在系统层面实现算力的反超。华为昇腾、寒武纪等厂商的实践证明,依靠集群技术,国产方案已能在千卡、万卡规模上提供具有竞争力的训练与推理能力。
#### 三、生态重构:从“兼容”走向“自主”
硬件的突围只是第一步,软件生态的短板曾是国产芯片最大的软肋。过去,CUDA生态的垄断让开发者难以迁移。如今,这一局面正在被打破。
国产芯片厂商正在采取“双轨并行”的策略。一方面,通过代码转换工具实现对CUDA的高覆盖率兼容,降低企业的迁移成本;另一方面,华为CANN、寒武纪NeuWare以及MindSpore等国产深度学习框架正在加速成熟。更值得注意的是,DeepSeek等开源框架的出现,开始原生适配国产指令集,分布式训练效率显著提升。这种从“被动兼容”到“主动定义”的转变,标志着国产AI芯片正在构建独立于Wintel和CUDA之外的第三极生态。
#### 四、市场验证:国产替代进入深水区
技术的成熟最终需要市场的检验。2026年的市场数据给出了积极的信号:在数据中心AI加速器领域,国产芯片的出货量占比已大幅提升,华为、海光、寒武纪、平头哥等厂商在政务、金融、能源等关键领域实现了规模化落地。
特别是非GPU架构的AI加速器出货量首次超过传统GPU,这显示出中国市场正在走出一条差异化的道路。通过“云-边-端”一体化协同,国产芯片不仅在云端训练上发力,更在边缘推理、工业物联网等场景展现出极高的能效比与性价比。
#### 结语
国产AI芯片的突围之路,注定不是一条坦途。它不再是简单的参数对标,而是一场涵盖架构设计、先进封装、软件生态与系统集成的全方位战争。虽然制程的差距依然存在,但通过架构创新与系统优化,中国芯片产业正在用“系统算力”弥补“单卡短板”。在这场突围战中,我们看到的不仅是技术的迭代,更是中国科技产业在极限施压下,从跟随者向引领者蜕变的决心与韧性。
- 上一篇:零基础上手AIPPT,快速入门教程
- 下一篇:人形机器人展望技术迈向新高度