AI芯片行业架构深度解读
2026-11-13
浏览量:次
### AI芯片行业架构深度解读:从“通用计算”到“专用加速”的范式重构
站在2026年的时间节点审视半导体产业,AI芯片已不再仅仅是计算机体系结构中的一个细分分支,而是成为了驱动数字经济与智能社会的“心脏”。随着大模型参数量的指数级跃升和应用场景的泛在化,传统的冯·诺依曼架构已难以应对海量数据吞吐与并行计算的需求。AI芯片行业的架构演进,本质上是一场为了打破“内存墙”与“功耗墙”,从通用计算向专用加速跨越的深刻变革。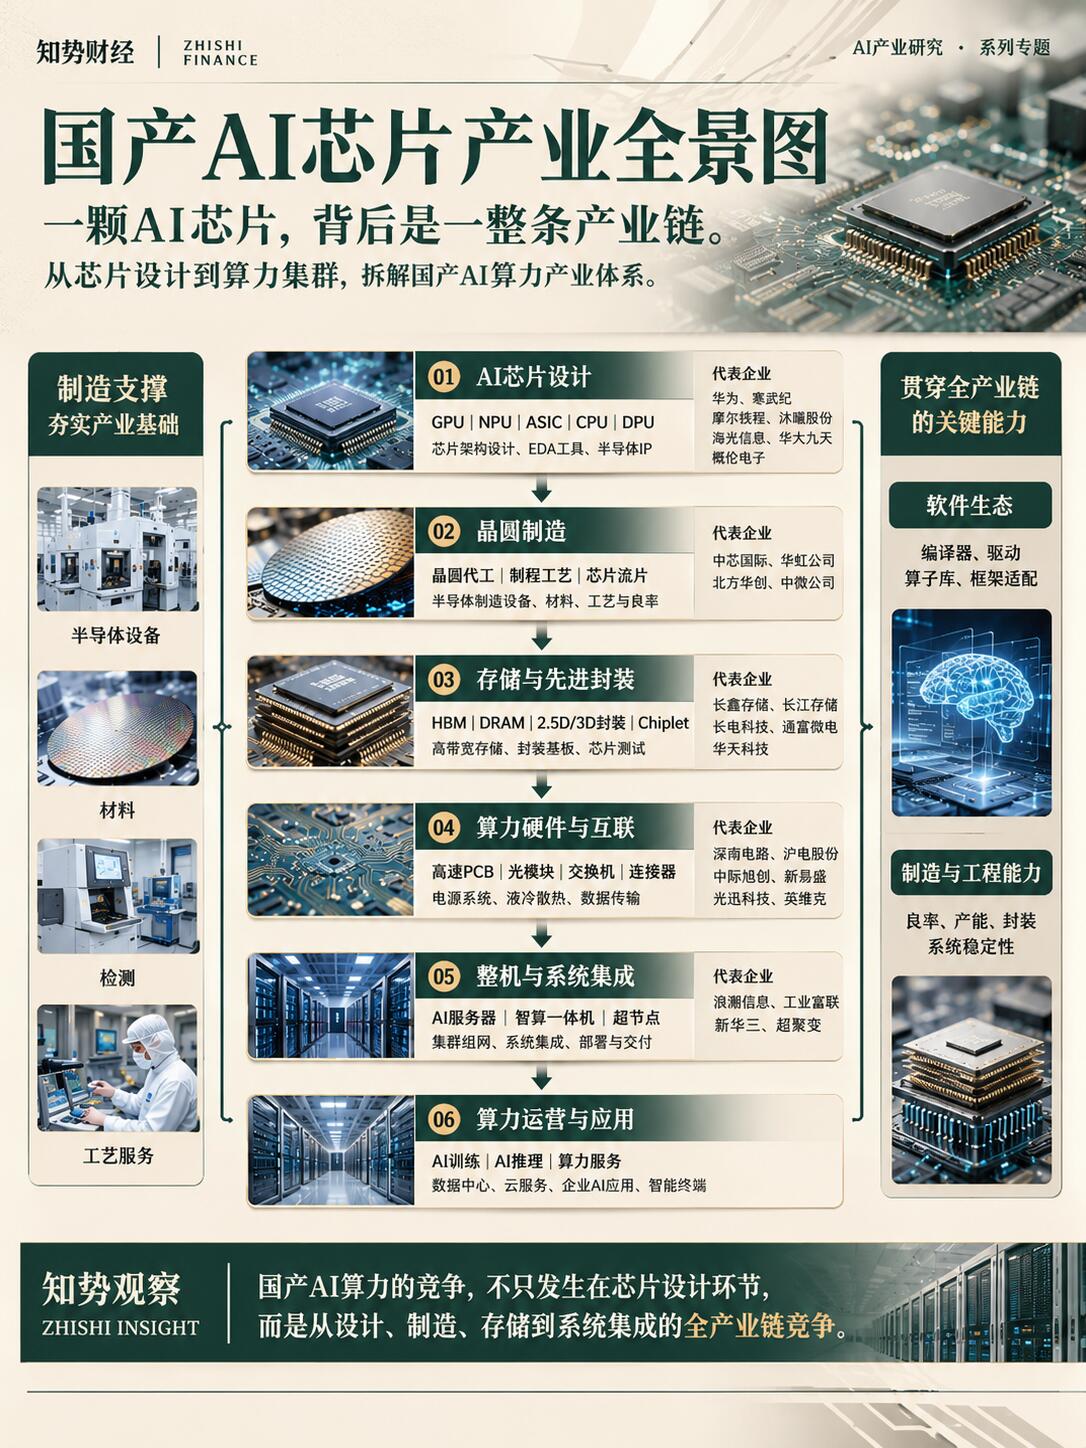
#### 硬件微观架构:计算、存储与互联的协同进化
AI芯片的硬件架构设计,核心在于解决深度学习算法中“算力需求大”与“数据搬运慢”之间的矛盾。不同于CPU以控制为核心的串行处理逻辑,AI芯片采用了以数据流为核心的并行处理架构,其内部结构主要由计算单元、存储单元、互联单元及控制单元四大核心模块深度耦合而成。
**计算单元**是AI芯片的“肌肉”。为了高效处理卷积、矩阵乘法等AI核心运算,现代AI芯片普遍采用了单指令多数据(SIMD)或单指令多线程(SIMT)的并行架构。除了基础的通用计算单元外,高端芯片集成了专用的张量计算核心(如Tensor Core)或神经网络处理单元(NPU)。这些专用单元通过脉动阵列等设计,能够在极低的功耗下提供惊人的算力密度。
**存储单元**则是AI芯片的“血管”。针对AI任务中“数据搬运耗时高于计算耗时”的痛点,行业架构呈现出明显的层次化与高带宽化趋势。片上多级缓存被用来极致优化数据访问速度,而外部存储则普遍采用高带宽内存(HBM)甚至3D堆叠技术,以解决内存带宽瓶颈。更前沿的架构开始尝试“存算一体”技术,将计算单元与存储单元物理融合,从根本上消除数据搬运的能耗。
**互联单元**与**控制单元**构成了芯片的“神经”与“大脑”。随着Chiplet(芯粒)技术的普及,互联单元不仅要负责芯片内部的数据传输,还要支持CXL等新型协议实现多芯片间的高速互联,以应对大规模分布式计算需求。而控制单元则通过集成专用指令集解码器,实现了对AI运算的精准调度与功耗的动态平衡。
#### 技术架构分类:通用与专用的博弈与融合
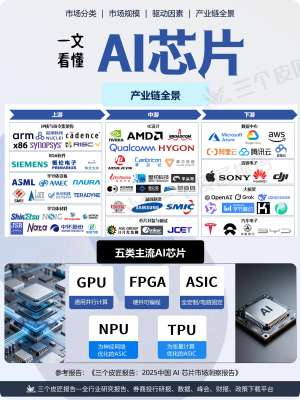
在宏观的技术路线上,AI芯片行业呈现出四种主流架构并存的局面,它们根据应用场景的不同,在灵活性、能效比和开发难度之间寻找着各自的平衡点。
**通用处理器优化型(GPU)**:这是目前生态最成熟的路线。GPU凭借数千个流处理器和高度并行的特性,在AI训练领域占据统治地位。通过在传统图形架构中引入专用的AI加速单元(如Tensor Core),GPU在保持通用性的同时大幅提升了AI算力,能够灵活适配各类算法框架。
**专用集成电路(ASIC)**:这是能效比的极致追求者。ASIC针对特定的AI算法(如深度学习推理)进行定制设计,去除了所有冗余逻辑。谷歌的TPU就是典型代表,它在特定场景下能提供极高的性能和极低的功耗,但代价是通用性较差,一旦算法发生颠覆性变化,芯片可能面临失效风险。
**神经网络处理器(NPU)**:作为ASIC的一种特殊演进,NPU聚焦于神经网络运算的共性需求(如矩阵乘、卷积)。它通过专用的指令集和架构设计(如寒武纪系列),在保持较高能效的同时,比传统ASIC具备更好的框架适配性,成为端侧和云侧推理的主流选择。
**现场可编程门阵列(FPGA)**:这是灵活性的代表。FPGA允许开发者在硬件层面重新定义电路结构,非常适合算法迭代极快、尚未定型的场景。虽然其开发门槛较高,但在低延迟推理和特定信号处理领域具有不可替代的优势。
#### 应用场景架构:云、边、端的三级火箭
AI芯片的架构设计最终服务于部署场景,目前行业已形成清晰的“云-边-端”三级架构体系。
**云端训练与推理**:这是算力的“航母”。云端AI芯片(如NVIDIA H100、华为昇腾系列)追求极致的算力密度和存储带宽,支持千亿级参数大模型的训练。它们通常部署在数据中心,通过高速互联网络组成算力集群,是人工智能的“大脑”。
**边缘端计算**:这是算力的“前哨”。边缘AI芯片部署在摄像头、网关等节点,侧重于实时性与低功耗。它们需要在本地完成数据的预处理和初步推理,减少上传云端的带宽压力,是智能制造和智慧城市的关键支撑。
**终端专用芯片**:这是算力的“毛细血管”。从智能手机的NPU(支持AI摄影、语音助手)到自动驾驶芯片(如特斯拉FSD,支持环境感知与决策),终端芯片极度强调能效比和集成度,让智能真正触手可及。
#### 未来演进趋势:打破物理极限的探索
展望2026年及未来,AI芯片架构的演进将围绕“更高能效、更强互联、更优生态”展开。
**异构融合与Chiplet技术**:单一工艺节点的微缩已近物理极限,通过Chiplet技术将不同工艺、不同功能的裸片(如计算芯粒、IO芯粒、存储芯粒)像搭积木一样封装在一起,成为提升良率和性能的主流路径。
**存算一体架构的成熟**:为了彻底解决“内存墙”问题,存算一体技术将从实验室走向产业化。通过在存储器内部直接进行计算,大幅降低数据搬运功耗,这将是边缘侧AI芯片实现“永远在线”的关键。
**软件栈的标准化**:硬件的竞争终将回归生态。随着ISO/IEC等国际标准的推进,以及国内AICL等适配工具的发展,跨平台、跨架构的软件兼容性将成为行业标配。未来的AI芯片竞争,将是“硬件算力+软件生态”的综合较量。
综上所述,AI芯片行业架构正处于一个从“暴力堆砌”向“精细设计”转型的关键期。无论是底层的电路设计,还是上层的系统架构,都在为迎接更通用的AGI时代积蓄力量。
- 上一篇:实测体验:AIGC赛道到底有多强?
- 下一篇:中国人形机器人化产业发展现状与趋势