AI芯片报告最新进展,性能再创新高
2026-10-30
浏览量:次
AI 芯片最新进展报告:性能再创新高
核心主线:本轮迭代不再单纯堆峰值 TOPS,访存带宽、稀疏计算、注意力硬件加速、CXL
内存池化、软硬协同成为突破重点;云端训练、端侧推理、车规、存算多条路线同步冲高,国产算力规模化落地加速。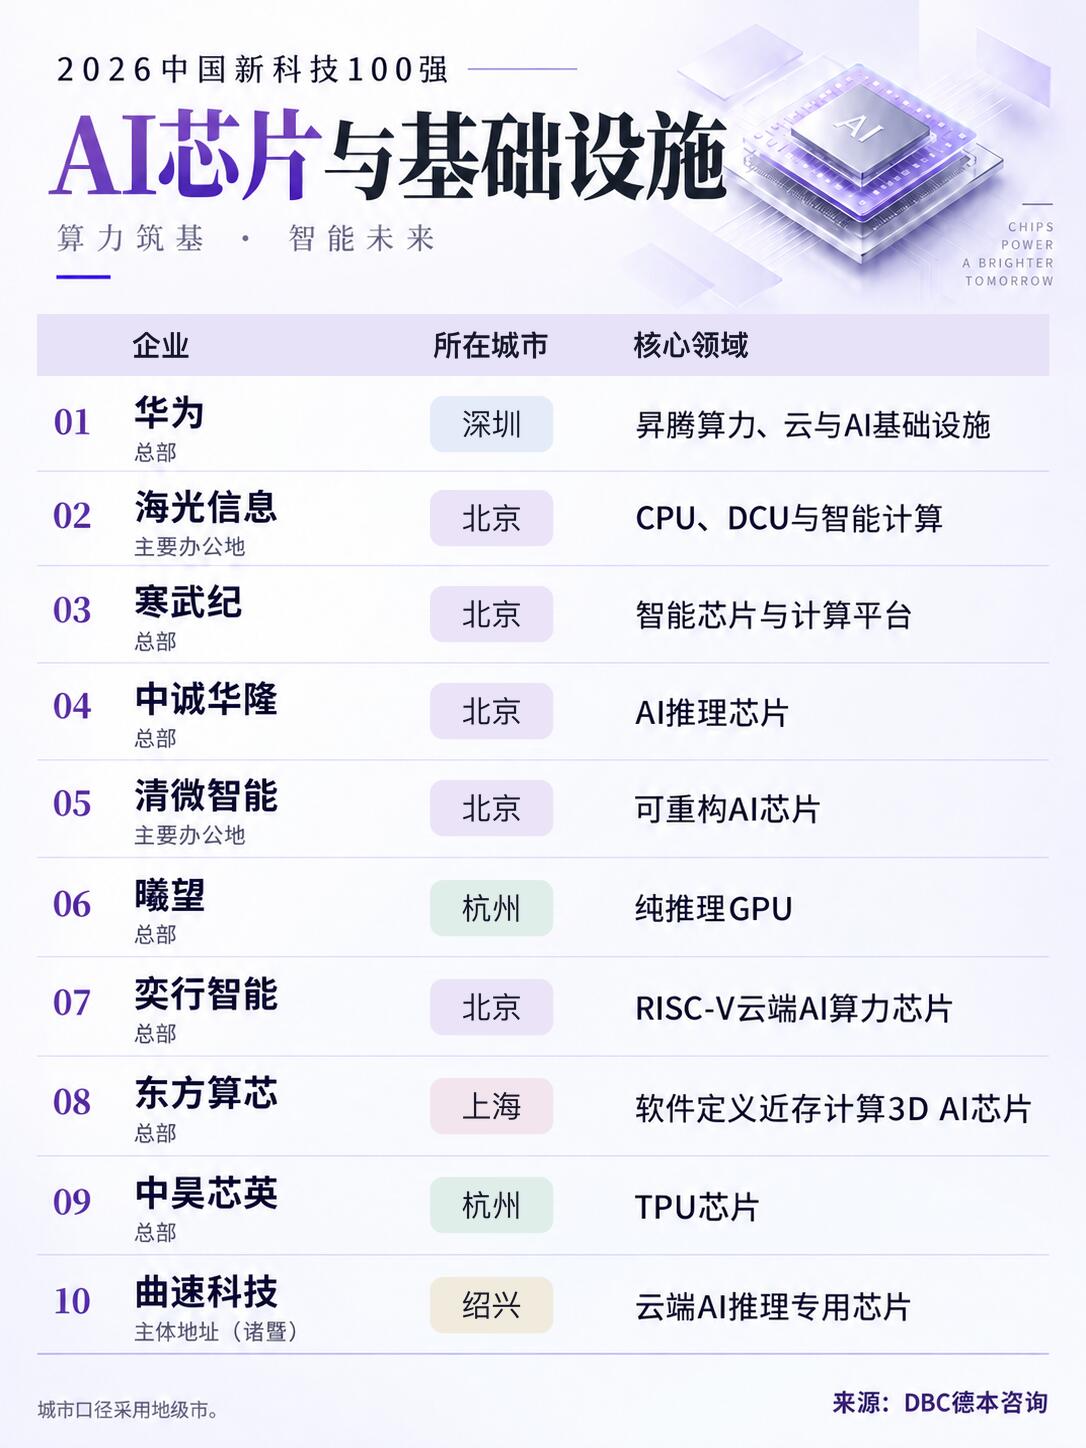
一、云端旗舰:算力、集群互联、显存墙持续突破
海外旗舰路线:新一代 GPU 强化 NVFP4 低精度、长上下文注意力硬件加速,HBM7、NVL 互联升级,单机架集群算力相比上一代 GB300 平台有数倍提升,重点面向视频生成、多模态大模型、超长上下文 Agent 训练推理;同时抬高显存容量与带宽,缓解大模型 KV 缓存瓶颈。
国产云端加速芯片:多款新片跨过千 TOPS(INT8)门槛,原生支持 BF16/FP16/INT4 混合精度、稀疏计算、CXL3.0 内存池扩展;重点优化大模型推理 KV Cache,在同功耗下吞吐明显提升。摩尔线程 MTT S5000 系列在智算中心批量部署,营收快速增长并实现扭亏,面向云厂商、AI 模型工厂交付万卡级集群方案。
架构趋势:从 “GPU 通用计算” 走向大模型原生架构,片上高速互联、近存计算、3D 堆叠混合键合方案增多,目标降低数据搬运功耗 —— 行业共识:AI 算力瓶颈早已不是计算单元,而是内存墙。
二、端侧 & 消费级 AI 芯片:能效爆发,本地大模型落地提速
Apple M6(2nm)+M5 Ultra 四晶粒封装:神经网络引擎升级,统一内存带宽拉到 170GB/s,Mac 端本地跑多模态、文生视频能力大幅提升,端侧 AI 任务能效优势突出Apple...。
移动旗舰 NPU:新一代移动端 SoC 的 NPU 算力突破 200TOPS,可在手机本地运行 70B 级别量化大模型,AI PC、手机端 Agent、实时图像视频生成成为标配方向。
边缘推理芯片:多款国产边缘 NPU 刷新能效榜单,部分型号综合能效超过 15 TOPS/W,适合摄像头、工业质检、物联网低功耗设备,不用上云即可完成多路视频分析。
三、车规 AI 芯片:兼顾高算力 + 功能安全
X7 Ultra 等新一代车规 NPU 主打高利用率架构,实测 NPU 利用率接近 99%,带宽开销大幅下降,单芯片承载更大参数智驾模型,支持激光雷达点云预处理,满足 ISO26262 功能安全,是 “端上车载大模型” 的核心底座;路线上不再只追求 TOPS 数字,更看重实时延迟、确定性调度、安全冗余。
四、两大创新路线:成熟工艺突围 + 存算一体验证推进
成熟制程路线(14nm 等):代表如 DF1000,采用晶圆级 3D 堆叠、软件定义近存计算,不依赖 3nm/2nm 先进制程,已经完成 128 卡集群稳定跑通,主打供应链自主可控,适合国内大规模智算扩容,成本可控、良率更稳新华网。
存算一体:在边缘推理场景持续迭代,直接在存储单元里做乘加,理论上大幅削减数据搬运功耗;目前在图像、语音类任务效果亮眼,但通用大模型、工具链、量产良率仍处在早期验证阶段。
五、实测里的关键变化(重点,贴合你前面 AIGC 汇总实测话题)
✅ 正向变化
同等算力下功耗持续下探,单卡大模型推理吞吐提升明显;
硬件原生支持 INT4、FP4 低精度,配合模型量化,性价比质变;
CXL、内存池化普及,集群可以弹性共享显存,解决 “单卡显存不够” 痛点。
现实短板(不要只看宣传跑分)
纸面 TOPS≠真实大模型速度:很多芯片峰值算力很高,但访存、算子优化、软件栈弱,实测跑 LLM 差距巨大;
生态仍是国产最大短板:编译工具链、算子库、框架适配、集群运维成熟度和海外头部还有差距;
长上下文、多模态视频生成任务对带宽、KV 缓存的压力远超传统文本大模型,很多新芯片在这类任务上容易被打回瓶颈;
先进制程、HBM 高端存储供给约束依然存在,抬高大规模扩卡成本。
六、产业落地方向
智算中心:从堆卡训练,转向训推一体集群,兼顾训练 + 7×24 推理、Agent 调用、视频生成;
行业算力:工业、医疗、金融、政务偏好成熟制程、可控供应链的算力方案;
端侧:AI PC、车载、机器人、边缘网关,走向本地优先、云端协同,降低延迟、保护数据隐私。
一句话总结
本轮 AI 芯片 “性能再创新高”,本质是算力、带宽、架构、内存池、工具链协同突破,不是简单数字竞赛;云端、车端、端侧三条赛道同时加速,国产芯片从可用走向规模化商用,但软件生态、高端存储供给、长上下文算力效率,仍是接下来核心攻坚点。