国产AI芯片化的突围之路
2026-10-15
浏览量:次
国产 AI 芯片化的突围之路
摘要
在高端 GPU 出口管制加剧、国内大模型算力需求爆发的背景下,国产 AI
芯片的突围不是单纯硬件参数追赶,而是架构创新、供应链补短板、软件生态共建、场景规模化落地的体系化工程。当前国内已经形成昇腾、寒武纪、燧原、摩尔线程、天数智芯等多条技术路线,在推理、智算集群、端侧
AI
取得规模化落地,但软件生态、HBM、先进制程、EDA仍是核心卡点。突围的核心思路:推理优先突破,训练稳步追赶;兼容迁移与原生架构双线并行;以场景养生态,用集群系统弥补单芯片短板。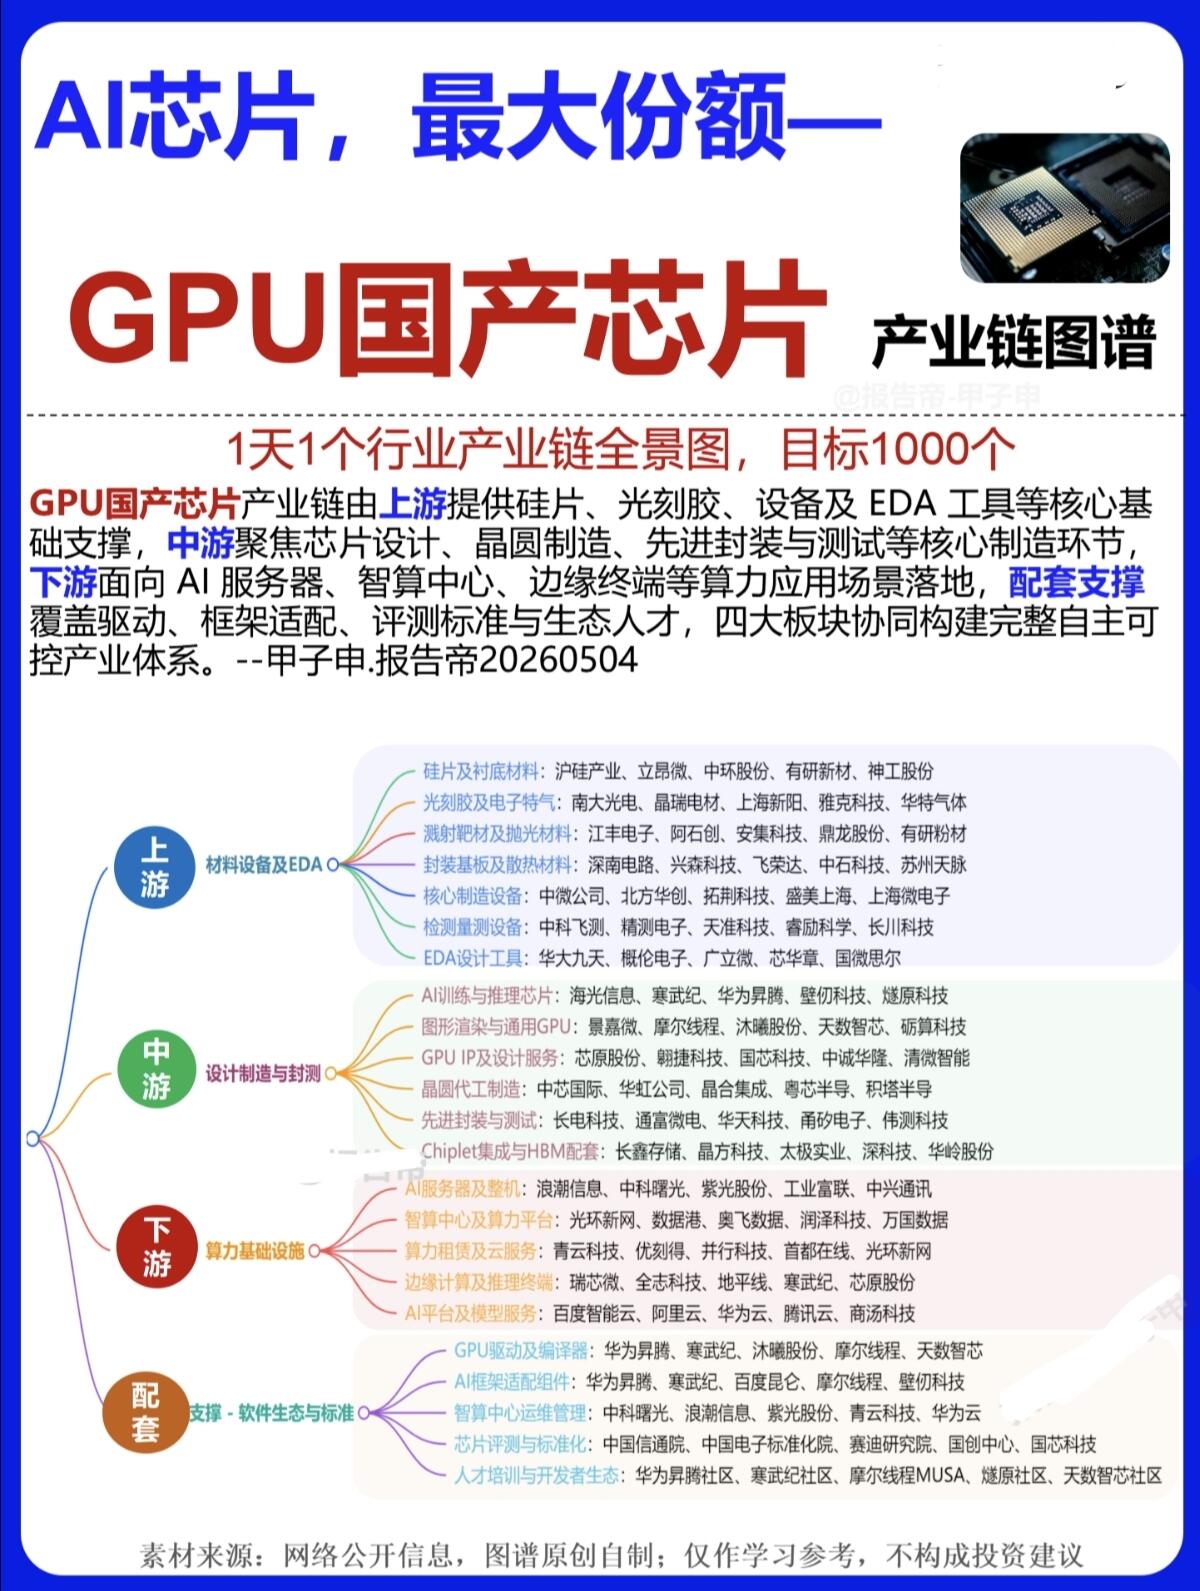
一、当前格局:机遇与核心困境
(一)机遇
国内 AIGC、大模型、智慧城市、自动驾驶、工业视觉催生海量算力需求,智算中心建设提速,形成巨大本土市场,给国产芯片提供迭代试验场。
外部算力封锁倒逼政企、云厂商主动做国产算力替代,政策、资金、算力基建协同支持。
芯片路线多元化:通用 GPU、DSA 领域专用架构、可重构、存算一体、端侧 BPU 并行发展,不再只跟随英伟达 GPU 单一范式。
(二)核心痛点(突围最大障碍)
软件生态壁垒(第一难题) 英伟达的护城河是 CUDA 生态,包含编译器、算子库、通信库、调试工具、海量开源模型,开发者长期绑定。国产芯片硬件纸面算力可以接近国际产品,但算子适配不全、编译优化不足,真实算力利用率常不足 40%;多家厂商各自一套软件栈,生态割裂,模型迁移成本极高电子工程专...。硬件差距可以靠封装、集群弥补,生态短板只能靠长期大规模场景迭代。
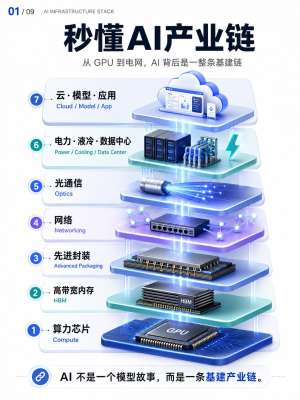
供应链卡脖子 先进制程受限;HBM 高带宽内存、高端载板、3D 先进封装、部分半导体设备与材料存在短板;高端 EDA 工具尚未完全自主,芯片设计验证环节仍依赖海外工具。Chiplet(芯粒)2.5D 封装成为短期重要替代方案,用成熟工艺叠加封装技术,弥补单芯片制程差距,但高端封装技术仍有差距电子工程专...。
训练芯片难度高于推理芯片 推理场景算力需求稳定、对通信带宽要求低,国产芯片更容易落地;大模型训练需要极强片间互联、HBM 显存、大规模集群协同,万卡级训练集群稳定性、通信延迟仍是短板。
人才短板 高端异构计算、编译器、底层架构、验证人才稀缺;芯片研发周期长、投入巨大,短期商业化回报压力大。
二、多元技术突围路线(差异化赛道,换道超车)
路线 1:DSA 领域专用架构(当前最成熟主力路线)
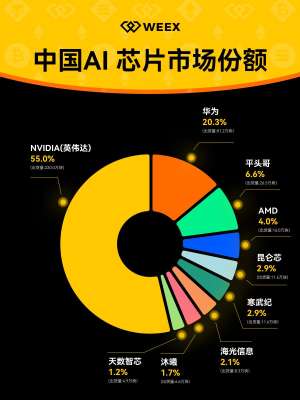
代表:华为昇腾达芬奇、燧原云燧、寒武纪 MLU。思路:不追求通用图形渲染,专为 AI 矩阵计算定制硬件单元,牺牲通用性换取 AI 场景下更高能效、更低功耗。优势:推理场景率先实现规模化商用,在大模型推理、内容审核、推荐、安防、智算推理集群性价比突出;昇腾已经实现千卡 / 万卡级训练集群落地,配套 CANN 全栈软件栈、MindSpore 框架形成完整闭环。定位:国内算力底座核心主力,政府、运营商、智算中心首选方案。
路线 2:兼容 CUDA 的通用 GPU 路线
代表:摩尔线程、天数智芯、沐曦。思路:硬件对标通用 GPU,软件层构建兼容层,降低原有 CUDA 模型迁移成本,让原有 AI 开发者低成本切换到国产硬件。优势:对存量 AI 模型友好,适合互联网企业快速迁移训练、推理业务;短板:底层仍在跟随 GPU 范式,长期看仍会受制于原有架构局限,完整算子兼容、大规模集群稳定性仍需要持续打磨。
路线 3:底层架构原始创新(中长期换道超车)
代表:清微智能可重构芯片、存算一体、类脑计算。思路:跳出传统冯诺依曼架构,解决 “内存墙” 瓶颈,芯片硬件可以动态重构计算阵列;不依赖先进制程,依靠架构创新提升算力效率。优势:成熟工艺下实现高算力,降低对高端制造依赖,适合边缘、端侧、低功耗场景;现状:目前处在产业化早期,短期内难以替代云端大模型训练芯片,是下一代算力的储备路线新华网客户...。
路线 4:云 - 边 - 端分层布局,优先抢占端侧与边缘
端侧 AI 芯片(寒武纪、地平线、地瓜机器人等)面向自动驾驶、机器人、工业视觉、智能摄像头。端侧场景对算力规模要求低、功耗优先,国产芯片已经大规模出货。战略价值:端侧是国产 AI 芯片率先实现盈利、积累工程经验、培育开发者生态的主战场,反哺云端芯片迭代。
三、突围实施路径:四大战略
1. 场景优先,先易后难,用市场迭代硬件与软件
优先从推理场景、行业垂直场景突破:智算推理、金融风控、内容审核、工业质检、智慧城市、机器人。策略:以场景养生态。云厂商、大模型企业与芯片厂商深度绑定,把真实业务跑在国产卡上,在大规模业务中持续打磨算子、编译器、集群通信。只有上万卡规模真实业务落地,才能发现硬件、软件、集群的隐性 bug,完成产品成熟度跃迁。
策略顺序:边缘端推理 → 云端大模型推理 → 中小规模模型训练 → 超大模型万卡训练集群。
2. 共建统一软件生态,破解生态碎片化
生态比单颗芯片更重要。
搭建统一适配平台、公共算子库、迁移工具,降低多框架(PyTorch、MindSpore)适配成本;
国内大模型企业、框架厂商、芯片厂商联合,打造国产软硬件协同标准,避免每家芯片一套独立软件栈;
建设开发者社区、培训体系,降低开发者学习成本,形成开发者飞轮。
3. 供应链分层突围:Chiplet 先进封装为短期抓手
先进制程短期受限,把重心转向Chiplet 芯粒技术:把不同工艺的芯粒封装在一起,用成熟工艺芯片叠加封装技术提升整体算力、显存容量,缓解 HBM、先进制程压力。同时分步补齐 HBM、封装载板、半导体设备、EDA、材料短板,构建全国产供应链体系。
4. 政策 + 资本协同,构建长周期研发机制
采用揭榜挂帅、赛马机制,集中资源攻坚训练芯片、互联、软件栈等核心卡点;引导资本理性投入,避免低水平重复内卷,鼓励企业深耕长期底层技术,不单纯比拼纸面 TOPS 算力指标。
四、挑战与风险预判
生态建设周期漫长:CUDA 生态用十几年建成,国产生态建设是十年维度的长期工程,短期难以一蹴而就。
国际持续技术封锁:出口管制可能持续加码,HBM、高端设备持续受限,供应链随时存在不确定性。
同质化内卷风险:大量企业扎堆云端训练芯片赛道,容易造成重复研发、产能浪费,忽视端侧、行业专用芯片。
算力利用率难题:即便硬件指标达标,集群通信、算子优化不足,依然会出现 “芯片算力很高,但跑模型实际速度上不去”。
五、总结
国产 AI 芯片的突围,不是单点硬件赶超,而是一场全产业链体系竞争。短期,依靠 DSA 专用芯片、Chiplet 封装,优先拿下推理与端侧市场,依托国内海量场景打磨软硬件;中期,完善统一软件生态,逐步向大模型训练集群渗透;长期,依托可重构、存算一体等底层架构创新,实现换道超车。核心逻辑:场景先行、生态为王、分层突破、体系自主。国产 AI 芯片会先在国内算力基础设施站稳脚跟,再逐步参与全球算力市场竞争。
- 上一篇:AIGC平台的版权与伦理问题探讨
- 下一篇:SLAM的感知与控制技术详解