AI芯片平台架构深度解读
2026-10-24
浏览量:次
AI芯片平台架构深度解读(2026版)
2026年AI芯片架构的核心变化是:竞争重心从“单卡峰值算力”转向“推理成本、能效比、系统互联、软件生态和场景适配”。过去看芯片主要看TFLOPS,现在更应看整柜系统、显存带宽、互联拓扑、精度支持、每Token成本以及能否稳定部署到具体业务中。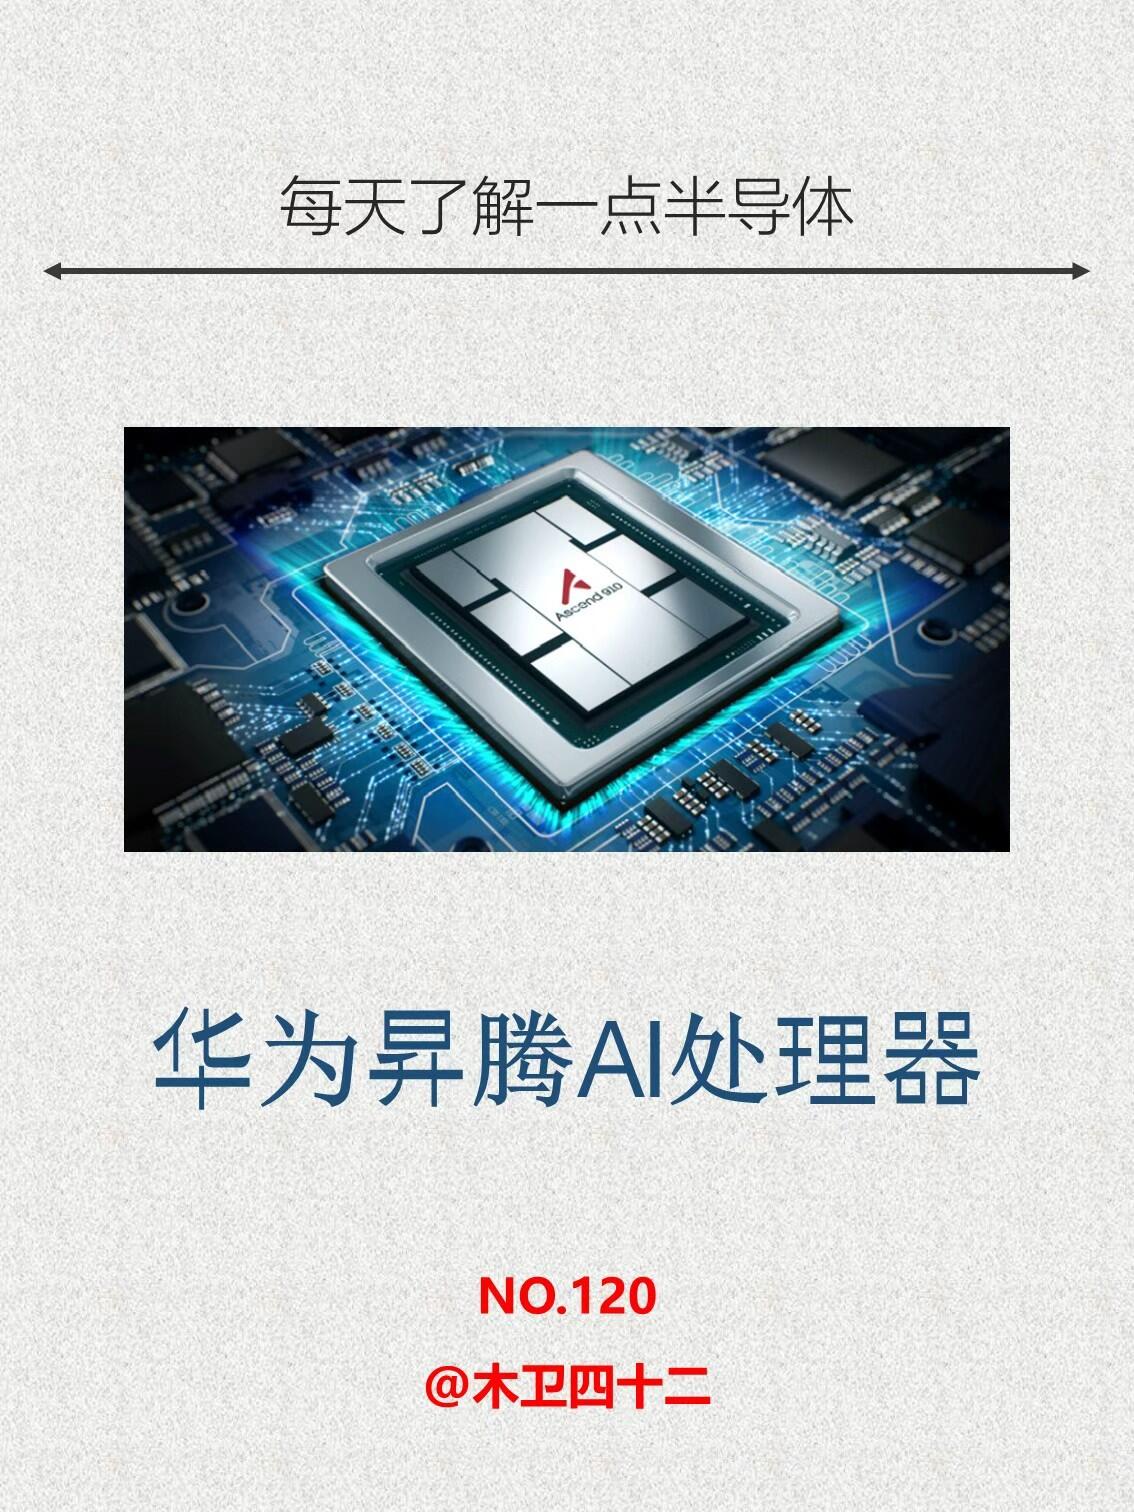
一、架构范式正在从“通用GPU”走向“异构平台”
AI训练阶段仍高度依赖通用GPU,但推理阶段正在出现更细分的架构:通用GPU、推理ASIC、NPU、LPU、存算一体、光计算、可重构DSA等并行发展。
英伟达在GTC 2026明确提出“推理拐点”:未来三年推理算力需求可能达到ChatGPT初始版本的上万倍。这推动平台从单一GPU升级为“CPU+GPU+DPU+LPU+高速互联+内存池化”的整柜系统。
二、主流平台架构拆解
1. 英伟达:从Blackwell到Rubin/Feynman,走向“整柜即芯片”
英伟达的架构优势不只是GPU强,而是全栈平台化。
Blackwell架构采用Chiplet设计、第五代Tensor Core和Transformer Engine,支持FP4/FP8等低精度推理,适合千亿级MoE模型训练与推理。
Rubin平台进一步升级为系统级方案:采用3nm Rubin GPU、Vera CPU、NVLink 6、ConnectX-9、BlueField-4 DPU,并引入Groq 3 LPU用于低延迟解码。其目标不是单纯提升单卡算力,而是把GPU显存、CPU内存和存储虚拟化成统一KV缓存池,专门服务长上下文推理和Agent工作流。
Feynman架构预计2028年推出,采用台积电1.6nm工艺,并计划通过3D堆叠集成Groq LPU的SRAM能力,进一步提升推理性能。它代表下一代方向:GPU主算力+确定性低延迟推理单元+超大SRAM缓存+光/铜混合互联。
2. AMD:CDNA推理性价比上升,ROCm生态补强
AMD的优势在于高显存带宽和Chiplet封装。MI300X、MI400X系列在推理场景中性价比突出,尤其是大显存版本适合长上下文LLM推理。
2026年ROCm生态明显改善,对PyTorch、vLLM、TensorRT-LLM等主流推理框架兼容性提升,部分推理代码迁移成本降低。但生产级算子覆盖、稳定性、工具链成熟度仍与CUDA有差距。
AMD架构特点是:计算芯粒+内存芯粒分离、Infinity Fabric互联、高带宽HBM、较低功耗密度,适合追求推理吞吐和成本控制的场景。
3. 华为昇腾:达芬奇NPU+全栈自主,政企与国产化首选
昇腾采用达芬奇架构,核心是NPU张量计算单元,配合CANN软件栈、MindSpore框架和Atlas集群方案。
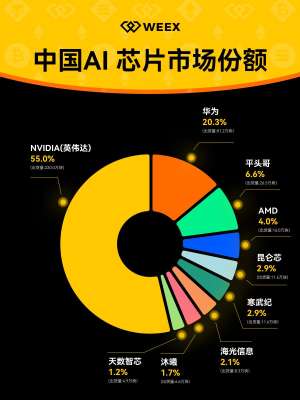
昇腾910C面向训练与大规模推理,昇腾950PR则更强调低精度推理能力,已适配DeepSeek、千问、文心等主流模型。其优势在于国产化供应链、政企合规、私有化部署和万卡集群能力;短板在于国际开发者生态相对弱,海外模型迁移仍需适配成本。
4. 专用推理芯片:LPU、SRAM架构和ASIC正在切分推理市场
Groq LPU代表一类特殊架构:用大规模片上SRAM替代HBM,通过确定性执行顺序减少内存访问不确定性,从而降低首Token延迟。它适合高并发、低延迟、固定模型的推理场景,但生态较封闭,通用性弱于GPU。
阿里真武M890、百度昆仑芯、谷歌TPU、亚马逊Trainium等属于云厂商ASIC路线:针对自有模型、自有框架和自有数据中心深度优化,能效和成本优势明显,但通用性有限。
5. 国产通用GPU:兼容CUDA生态,适合迁移与替代
海光、沐曦、摩尔线程、壁仞、天数智芯等走的是通用GPGPU或类GPU路线,部分产品强调CUDA兼容或生态迁移能力。
这类芯片的价值在于:在国内信创、私有云、行业大模型推理场景中提供可用替代方案。但高端训练能力、算子完备度、大规模集群稳定性仍是关键考验。
三、底层架构创新:决定下一代算力上限
1. Chiplet与先进封装
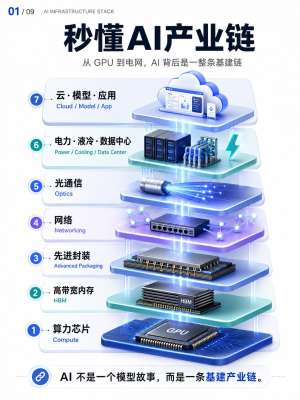
Chiplet把计算、存储、I/O拆成不同小芯片,再通过2.5D/3D封装集成。它可以绕开单一先进制程限制,降低大芯片良率风险,也是Blackwell、MI300/MI400、国产加速卡普遍采用的路线。
未来趋势是“封装即系统”:芯片性能越来越依赖CoWoS、Foveros、SoIC等先进封装和片间互联能力。
2. 存算一体
传统GPU最大瓶颈之一是“内存墙”:数据在DRAM/HBM与计算单元之间反复搬运,能耗高、延迟大。存算一体把计算搬到存储附近,甚至在存储单元内完成矩阵运算。
SRAM存算更适合云端低延迟推理,RRAM/模拟存算更适合边缘端低功耗场景。它的挑战在于精度控制、工艺成熟度、编译器适配和大规模量产良率。
3. 光互连与光计算
光互连主要解决集群带宽问题。CPO共封装光学能把光模块更靠近芯片,提升带宽密度并降低功耗,正在成为超大规模AI集群的关键方向。英伟达Rubin Ultra及后续平台已明确向光铜混合、CPO演进。
光计算则更前沿,它用光子完成矩阵乘法等线性运算,理论上具备超低延迟和低功耗优势。但目前更适合特定推理任务,距离全面替代GPU仍早,短期更可能以“光电混合加速”形式落地。
4. 数据流与可重构架构
传统冯·诺依曼架构受限于“取指—译码—执行—访存”流程,数据搬运开销大。数据流架构让计算随数据流动触发,可重构DSA则允许根据不同模型动态调整硬件资源。
这类架构在端侧AI、工业视觉、机器人、低功耗推理中优势明显,但通用编程难度较高,需要更强编译器支撑。
四、软件生态仍是最大护城河
硬件决定上限,软件决定落地。英伟达CUDA、TensorRT、TensorRT-LLM、NVLink/NVSwitch生态仍然最强,开发者迁移成本最高。
AMD ROCm在2026年进步明显,但生产环境稳定性仍需验证。华为CANN在国内政企场景加速成熟,但国际开源生态活跃度有限。Groq、Cerebras等专用架构性能强,但编译器封闭、模型适配范围窄。
因此选型时不能只看算力,还要看:模型是否原生支持、算子是否完备、推理框架是否稳定、量化/分布式/服务化是否成熟。
五、按场景看架构选择
千亿参数训练:优先看NVLink/高带宽HBM/整柜互联能力,Blackwell/Rubin平台仍占优势。
长上下文推理:更看重显存容量、KV Cache管理、内存池化和低延迟解码。
高并发低延迟推理:LPU、SRAM架构、专用ASIC可能更合适。
政企国产化部署:昇腾、寒武纪、国产GPGPU是主要选项。
边缘/端侧AI:存算一体、低功耗NPU、AI PC/车载芯片更关键。
超大规模集群:CPO光互连、无缆化背板、DPU存储卸载会成为系统瓶颈解法。
六、判断AI芯片平台的六个关键指标
精度覆盖:是否原生支持FP4/FP8/BF16/INT8,低精度推理是否稳定。
显存与带宽:大模型推理中,带宽往往比峰值算力更敏感。
互联能力:NVLink、Infinity Fabric、UCIe、CPO决定多卡/多机柜扩展效率。
系统级能效:看每瓦推理吞吐、每Token成本,而不是只看单卡TFLOPS。
软件栈成熟度:框架适配、算子覆盖、量化、服务化部署能力决定真实可用性。
供应链与合规:出口管制、国产替代、私有化部署需求会直接影响选型。
整体看,2026年AI芯片平台已经不再是“谁单卡更强”的简单竞争,而是“芯片+封装+互联+存储+编译器+推理框架+数据中心架构”的系统竞争。短期训练仍由高端GPU主导,中期推理会被专用架构持续切分,长期存算一体、光互连和3D堆叠会重塑算力基础设施。
- 上一篇:AIGC指南工具推荐与使用技巧
- 下一篇:专家娱乐机器人技术迈向新高度