AI芯片大全技术突破打破国外垄断
2026-10-20
浏览量:次
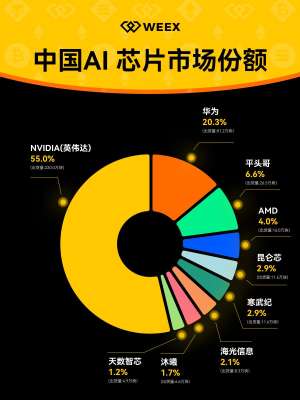
2026年国产AI芯片已从“能用”进入“好用、可规模替代”阶段。国内AI加速卡市场中,国产芯片整体份额已突破50%—60%,在推理场景尤其明显;但高端制程、EDA工具、HBM存储和CUDA生态上,仍与英伟达、台积电、三星等存在差距,尚未实现全面超越。
市场格局:从英伟达主导向“一超多强”转变
2026年国产AI芯片呈现“一超多强”格局。华为昇腾以近40%国产出货占比领跑,寒武纪、海光信息、沐曦、摩尔线程、壁仞科技、阿里平头哥、百度昆仑芯等构成第二梯队。
截至2026年上半年,中国智能算力规模已达2185
EFLOPS,同比增长177%;首个全国产10万卡AI超集群正式投用,芯片、计算、存储、网络、散热等核心软硬件均采用国产自主可控技术。美团LongCat-2.0万亿参数模型也实现了在国产芯片上的全训练闭环,标志着国产算力从“替代”走向“训练闭环”。
主流国产AI芯片盘点
华为昇腾系列
昇腾910B/910C:量产主力,910C支持万卡集群,FP16算力800TFLOPS,万卡集群算力可对标英伟达H200。
昇腾950PR/DT:2026年推出,FP4算力1.56PFLOPS,对标并超越H200,DeepSeek-V4已将其纳入硬件验证清单。
昇腾384超节点:已商用超750套,是国内唯一规模商用的超节点方案。
寒武纪
思元590:推理性能达H100的120%,FP16算力384TFLOPS。
思元690:2026年初量产,4nm双die封装,FP16算力超700TFLOPS,配备196GB HBM3。
海光信息
深算二号/三号DCU:兼容ROCm/CUDA生态,推理性能达H100的80%,已适配365款主流大模型。
深算四号:搭配自研交换芯片,显著提升集群互联能力。
摩尔线程
MTT S5000:FP8算力1000TFLOPS,推理性能达H100的95%,支持图形+AI双负载。
沐曦股份
曦云C600/C500:通用GPU路线,C500推理性能达H100的110%。
百度昆仑芯
P800:FP16算力345TFLOPS,已实现3.2万卡集群部署。
壁仞科技
BR100/壁砺166:聚焦万卡级大模型训练,INT8推理能效突出。
端侧芯片
中星微星光智能五号:单芯片5W功耗运行16B大模型,8颗可支持6710亿参数DeepSeek。
后摩智能M50:存算一体架构,10W功耗运行30B-120B参数模型。
地平线星空Starry 6P:5nm车规级,650TOPS,舱驾融合。
核心技术突破
架构创新弥补制程差距
东方算芯DF1000采用软件定义+3D近存计算架构,在14nm国产制程上实现520TFLOPS@BF16算力,性能等效海外4nm主流GPU,不依赖EUV和HBM。华为麒麟2026芯片采用"逻辑折叠"技术,在DUV条件下晶体管密度接近台积电3nm水平。
制造与存储突破
中芯国际7nm工艺良率超90%,5nm风险量产,3nm验证良率突破65%。长江存储294层3D NAND量产,全球份额约13%。长鑫HBM3处于量产初期。
超节点与集群能力
华为昇腾384超节点打破冯诺依曼架构,实现384卡大带宽低时延互联,跨节点通信带宽提升15倍。中科曙光ScaleFabric实现400Gb/s无损传输。
软件生态加速追赶
华为CANN全面开源,壁仞BIRENSUPA实现与通义千问、DeepSeek的Day0适配。DeepSeek-V4底层代码已从CUDA迁移至CANN框架。
仍存在的差距
先进制程:7nm量产,距台积电2nm约2-3代,EUV完全自主预计需10年以上。
EDA工具:国产市占率不足5%,高端数字设计工具缺失约20%。
HBM存储:长鑫HBM3量产初期,与韩国差距约3-5年。
生态壁垒:CUDA生态迁移成本仍高,集群训练效率(昇腾互联200GB/s vs NVLink 900GB/s)仍有差距。
总体来看,2026年国产AI芯片在推理场景已实现规模化替代,训练场景通过集群优化逐步追平,架构创新正在开辟不依赖先进制程的新路径。但要在高端制程、存储、EDA和生态上全面打破垄断,仍需持续投入和时间积累。
- 上一篇:AIGC总结的版权与伦理问题探讨
- 下一篇:专家人形机器人与人协作的未来工作场景