AIGC平台的版权与伦理问题探讨
2026-10-15
浏览量:次
AIGC 平台的版权与伦理问题探讨
一、引言
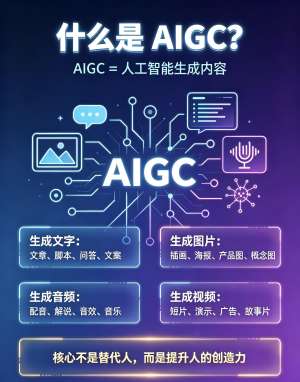
AIGC(生成式人工智能)依托海量文本、图像、音视频等数据训练模型,能够自动生成文字、图片、代码、视频等内容。以
ChatGPT、Midjourney、文心一格等为代表的 AIGC
平台快速普及,在赋能创作、提升生产效率的同时,训练素材版权争议、生成内容权属、虚假信息、歧视偏见等版权与伦理矛盾集中爆发,成为行业发展不可回避的核心议题。
二、版权层面核心争议
(一)训练数据:模型学习是否构成侵权
这是当前 AIGC 版权争论最核心的问题。
争议焦点:模型训练过程抓取互联网公开文章、绘画、摄影、小说等作品,不经过原作者授权、不支付报酬。平台方认为属于合理使用,只是提取数据特征,不复制原作本身;创作者群体则主张,模型本质是依靠他们的作品 “学习”,商业使用模型应当获得授权并付费。
不同地区法律差异
美国:判例尚未完全定论,部分诉讼(如作家、艺术家起诉 OpenAI、Stability AI)仍在审理,对 “合理使用” 边界存在巨大分歧。
欧盟:《AI 法案》《版权指令》要求,使用受版权保护作品训练模型,商业用途原则上需要权利人许可;非商业研究场景可例外。
中国:《生成式人工智能服务管理暂行办法》明确,AIGC 服务提供者应当尊重知识产权,不得侵害他人依法享有的知识产权。我国著作权法中,单纯 AI 模型训练是否属于合理使用尚无明确法条,司法实践仍在探索。
(二)生成内容的著作权归属问题
AI 生成内容能不能享有著作权? 著作权制度建立在人类创作基础上。多数国家现行法律认为:纯 AI 自主生成、没有人类独创性投入的内容,不属于作品,不享有著作权。若用户进行大量提示词设计、筛选、修改,投入显著创造性劳动,人类用户可在对应成果上享有著作权。
风险点
AIGC 输出可能原样或近似抄袭现有作品,用户难以肉眼识别,极易无意识侵权;
平台协议常常设置复杂条款:有的平台声称拥有模型产出内容权利,有的授予用户使用权,但限制商用,不同平台规则不统一,用户商用时极易踩坑。
(三)衍生侵权与商用责任划分
当用户使用 AIGC 生成图片、文案用于广告、出版物,发生侵权时,责任到底由平台、提示词用户,还是模型开发者承担,目前没有统一标准。
平台视角:仅提供工具,内容由用户指令生成,平台不担责;
权利人视角:平台明知模型训练吸收大量版权作品,应当承担审核义务。
三、伦理层面突出问题
(一)算法偏见与歧视固化
训练数据来自互联网,自带历史偏见、刻板印象。模型会复刻数据里的性别、种族、地域偏见:例如求职、法律场景下的差异化判断,对特定群体的负面描述。
伦理困境:偏见不是开发者刻意编写,但模型会放大社会原有偏见,并且偏见藏在模型内部,难以溯源、难以消除。
(二)深度伪造(Deepfake)与虚假信息风险
AIGC 可以低成本生成逼真伪造人像、语音、视频,伪造他人言论、证件。
恶意场景:造谣诽谤、电信诈骗、伪造新闻、伪造名人发言;
危害:冲击信息真实性,损害个人肖像权、名誉权,扰乱公共舆论。
(三)对人类创作者的冲击与劳动伦理
低门槛 AIGC 替代基础文案、插画、剪辑等基础创意岗位,带来短期失业与行业收入挤压;很多创作者认为自己的作品被无偿拿去训练,再反过来被 AI 工具替代。
创作价值贬值:大量流水线式 AI 内容泛滥,降低原创内容辨识度;大量低质 AI 内容充斥网络,形成 “内容污染”。
辩证看待:AI 是工具,能够辅助创作者,但是缺乏配套分配机制时,会损害创作者群体利益。
(四)隐私泄露伦理风险
训练数据中可能混入未脱敏的个人信息:身份证、聊天记录、私人照片。模型在生成时,有可能记忆并泄露个人隐私;用户输入到 AIGC 平台的提示内容,若被用于模型迭代,也存在用户数据隐私泄露风险。
(五)真实性缺失:AI 幻觉带来的伦理危害
大模型会编造不存在的文献、法条、事实、引用。当用户不加核验直接用于论文、新闻、法律文书、医疗建议,会造成误导,严重时损害他人权益甚至危及人身安全。AI 不具备 “判断真假” 的价值判断能力,只追求文本通顺。
四、国内外治理实践
中国《生成式人工智能服务管理暂行办法》 要求平台落实内容审核;禁止生成虚假有害信息;尊重知识产权;采取措施防范算法偏见;AI 生成内容应当采取标识等方式区分 AI 生成内容。
欧盟《AI 法案》 将深度伪造类生成内容要求强制标注;高风险 AI 系统进行合规评估;训练数据版权合规审查。
美国 以司法诉讼推动规则形成,暂无专门 AIGC 立法,依靠版权法、肖像权现有法律框架调整。
五、平衡路径与对策建议
1. 版权机制:建立 AIGC 训练素材授权体系
区分商用 / 非商用模型,商业模型使用受版权作品训练,建立集体授权机制,向创作者支付数据使用费;
完善作品溯源、水印技术:AI 生成内容添加数字水印,便于识别 AI 产出,追踪来源。
2. 平台责任:压实 AIGC 平台义务
训练前做好数据清洗,剔除侵权内容、隐私信息、歧视性内容;
完善输出审核,对深度伪造等高风险内容增加识别拦截;
清晰公示用户协议,明确生成内容的使用权限、商用边界。
3. 用户层面:树立风险意识
商用前核查 AIGC 成果是否侵权;对 AI 生成事实类信息交叉核验;传播 AI 内容主动标注 AI 生成,避免伪造混淆。
4. 技术手段辅助治理
数字水印、内容溯源技术、模型可解释性研究,降低偏见、幻觉带来的风险。
5. 社会层面:重构创作生态
将 AIGC 定位为创作辅助工具,完善创作者收益补偿机制,而不是简单替代人类创作;建立行业伦理准则。
六、总结
AIGC 版权问题本质是传统著作权体系,面对 AI 大规模自动学习的新生产方式出现的适配危机;伦理问题则是算法权力、信息真实性、人的尊严与劳动价值之间的冲突。 AIGC 不是天然向善或者天然有害,技术本身中立,关键在于法律规则、平台治理、行业伦理共同约束。未来的方向不是禁止 AIGC,而是构建兼顾创作者权益、AI 创新发展、公众信息安全的平衡机制。
- 上一篇:2026年ChatGPT前景发展趋势预测
- 下一篇:国产AI芯片化的突围之路