AIGC概览技术原理通俗解读
2026-10-28
浏览量:次
AIGC 概览 + 技术原理(通俗版,适合汇报、讲课)
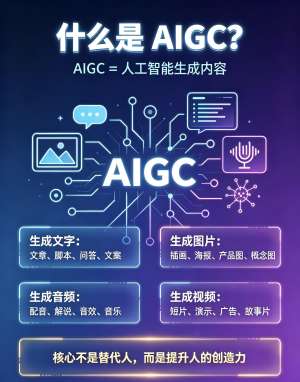
一句话先记住:AIGC 就是人工智能,看完海量内容之后,学会 “猜下一个合理内容”,然后从头生成文字、图片、音频、视频。 AIGC 全称:AI Generated Content,人工智能生成内容,ChatGPT、文生图、AI 配音、AI 视频都属于 AIGC。
对比区分,更好理解:
传统 AI(识别类):看懂这张图是什么、听懂这句话在说啥 → 理解、识别
AIGC:给一个想法,凭空产出新图文音视频 → 创造、生成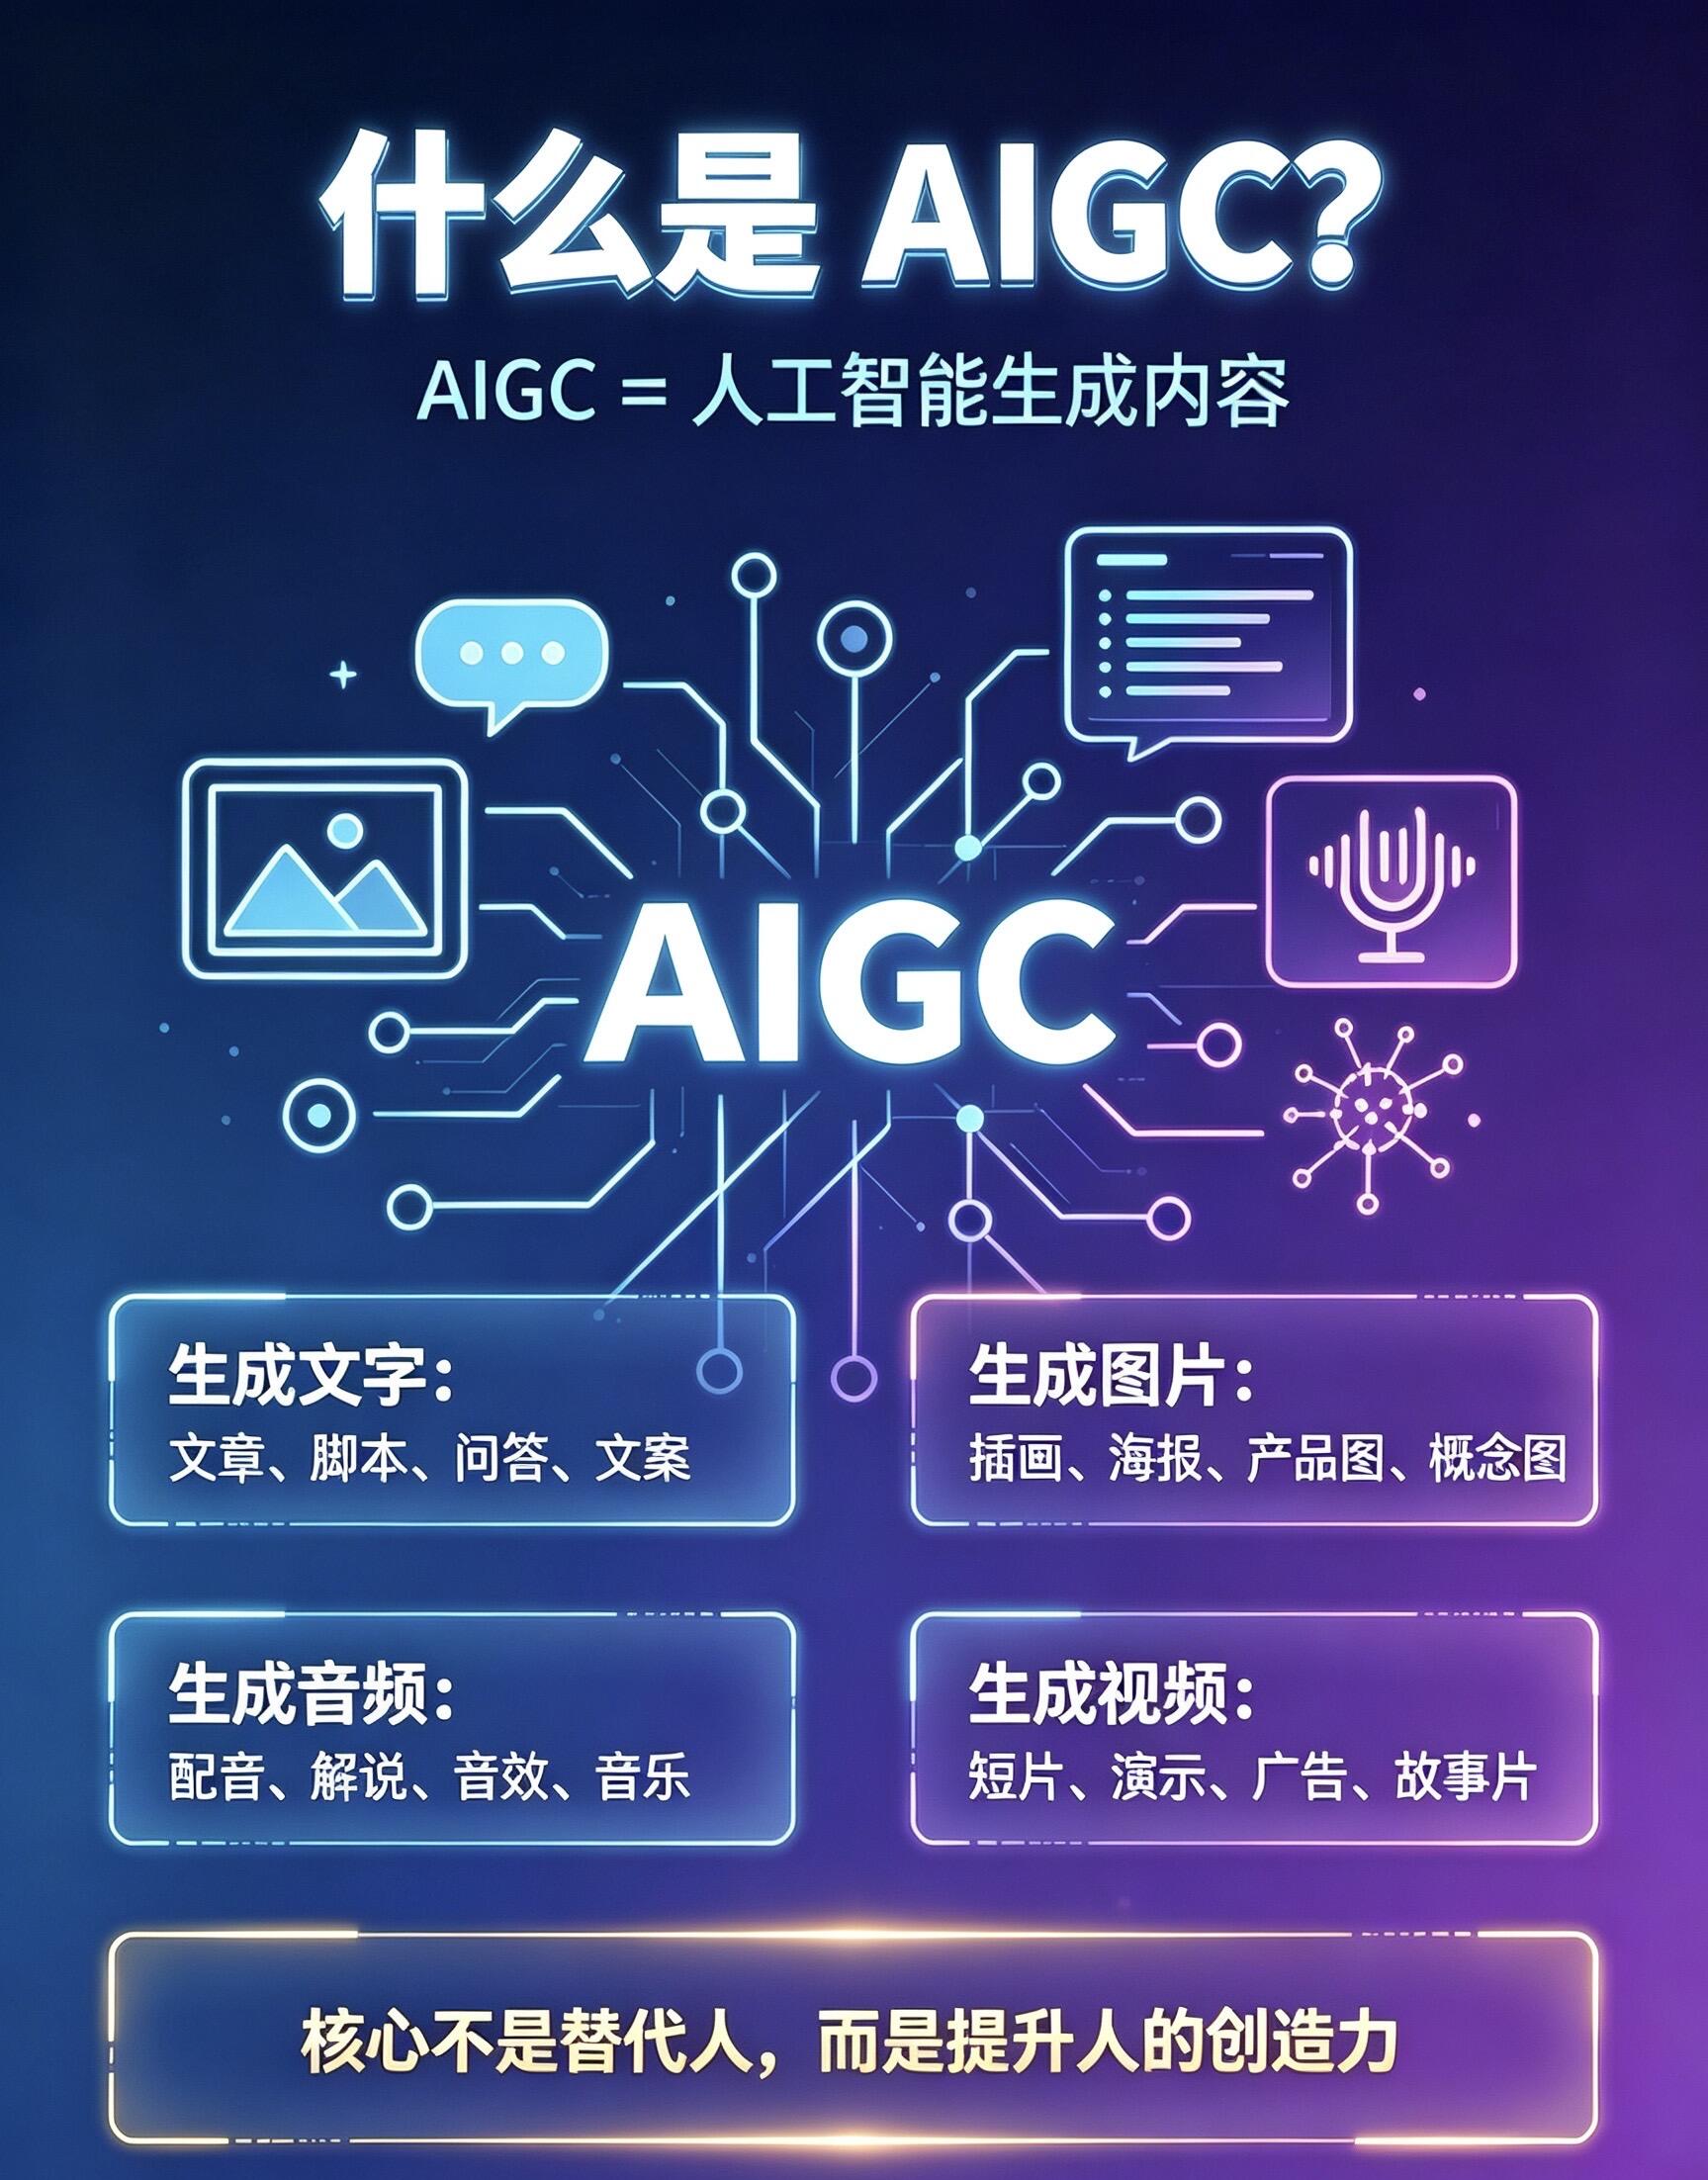
一、AIGC 大家族有哪些(概览)
文本生成:ChatGPT 这类大语言模型,写文案、回答、代码、剧本
图像生成:Stable Diffusion、Midjourney,文字转图片、图生图、扩图、修图
音频生成:AI 配音、歌声克隆、音效生成
视频生成:文生视频、图生视频、数字人视频
多模态生成:同一个模型既能看懂文字、图片,又能输出图文视频(现在主流方向)
二、核心原理通俗拆解
1. 大语言模型(文字 AIGC,GPT 路线):预测下一个词
它不是 “有思想、懂道理”,核心逻辑超级简单:训练的时候,喂给它互联网海量文章、书籍、对话。它统计、学习文字之间的搭配规律、逻辑、语法。当你输入提示词:写一段春天的文案 它就一个词一个词,不断猜 “接下来最通顺、最合理的词是什么”,拼接起来,就是回答。
重点:它是概率猜词,不是 “真的理解”。所以会出现幻觉—— 为了句子通顺,编造不存在的事实、数据,它自己不知道真假。
2. 文生图模型(扩散模型 Diffusion,SD、MJ 主流):给图片 “慢慢去噪”
这个是图片 AIGC 最核心的技术,很多人听不懂,通俗讲:想象一张清晰的照片,我们不断往上面撒椒盐、加雪花噪声,直到最后完全变成乱糟糟的噪点图。训练阶段:AI 反复看【噪点图 → 慢慢去掉噪声,变回原图】这个过程,学会怎么除噪。
使用的时候:你输入提示词:“湖边日落,小猫” AI 先拿一张完全随机的噪点图,一步一步,一点点擦掉噪声,每一步根据文字提示,把噪点修正成符合描述的画面,几十步之后,一张完整图片就出来了。
一句话扩散模型:从乱码噪点,逐步还原成符合文字描述的画面。
补充:早期文生图用 GAN 生成对抗网络,容易畸形、不稳定,现在基本被扩散模型取代。
3. 音频、视频 AIGC
AI 语音:学习海量人声,把文字转换成符合音色、停顿、情绪的音频波形;
AI 视频:两种主流思路 基于图片扩散,一帧一帧生成画面,再保证帧和帧之间画面连贯; 原生视频大模型,直接学习视频时序信息,一次性生成连续短片。
4. 多模态 AIGC(现在的趋势)
模型同时学文字、图片、声音。既能看图回答问题,也能根据文字画图,打通不同形式的内容。
三、两个高频名词通俗解释(汇报必用)
提示词 Prompt:你给 AI 的指令,相当于给 AI 的 “命题要求”,AI 好不好看提示词写得清不清楚;
RAG 检索增强:通用 AI 知识老旧、容易瞎编。把自己的文档、资料放进知识库,AI 回答前先查资料,再组织语言,减少幻觉,企业场景最常用;
微调 Fine-tune:拿行业专属数据,在成熟模型上继续训练,让它适配专业领域(医疗、工业、法律)。
四、AIGC 整体工作流程(通用)
用户输入提示词(文字 / 图片)
模型读取指令,调用学到的海量规律
按自身算法(大模型猜词 / 扩散去噪)一步步生成内容
输出结果(文字 / 图 / 音视频)
(可选)人工筛选、二次修改、校验内容
五、优势和天生短板
✅ 优势:出内容快、低成本、风格可控、降低创作门槛 ❌ 短板:
幻觉:编造事实、参数、文献(最头疼)
生成内容容易同质化,缺少独特深度思考
版权、内容安全、数据隐私风险
复杂物理、专业工程场景容易出错,必须人工复核
六、一句话收尾总结(适合 PPT 结束语)
AIGC 本质不是真正拥有创造力,而是从海量已有内容里学到模式,按照我们的指令,用概率算法,自动生成符合要求的新内容;它是创作者、企业的效率工具,而不是可以完全自主思考的智慧生命。
- 上一篇:ChatGPT式如何赋能千行百业?
- 下一篇:AI芯片总结产业链投资机会