AIGC技术的版权与伦理问题探讨
2026-10-21
浏览量:次
AIGC 技术的版权与伦理问题探讨
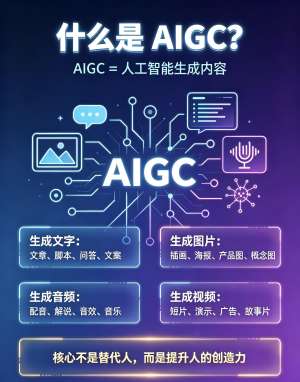
AIGC(生成式人工智能)依托海量已有文本、图像、音频、视频等数据训练模型,在快速赋能创作的同时,版权边界模糊、伦理风险交织,目前全球尚未形成统一、成熟的治理方案,下面分版权问题、伦理问题、争议焦点、治理思路四部分客观梳理。
一、版权层面核心争议
版权矛盾的根源:模型训练是否属于侵权使用,以及生成内容能不能获得版权保护。
1. 训练数据的版权定性(最大分歧点)
模型训练需要抓取互联网公开作品(绘画、小说、照片、音乐、论文)。
支持合理使用一方:训练属于转换性使用,模型学习的是风格、特征、规律,不是复制原作本身;训练过程是非表达性的数据统计,不替代原作市场,符合合理使用。
反对一方:大量创作者没有授权,模型未经许可批量抓取作品,以他人创作成果为商业基础盈利,挤压创作者生存空间,属于大规模侵权。
现实现状:各国判例方向分化。美国现阶段部分判例倾向区分 “提取表达” 和 “学习特征”;欧盟 AI 法案、国内法规更强调数据来源合规、优先获得授权;大量图库、画师、作家集体起诉 AIGC 厂商。补充:公开可访问 ≠ 可以随便抓取用于 AI 训练。
2. AIGC 生成内容的版权归属
纯 AI 自动生成,没有人类实质性创作投入:多数国家(包括我国现行司法口径)不赋予著作权。著作权保护的是人类智力成果,单纯机器输出不属于作品。
用户提供详细提示词、反复调参、筛选修改,形成人类实质性创作贡献:满足独创性要求时,人类使用者可以成为著作权人。
关键判定标准:人类有没有进行独创性构思、取舍、修改,而不是简单一句 “画一张古风图”。提示词越简单,越难拿到版权;深度策划、迭代调整,获得版权的可能性越高。
3. 衍生侵权风险:风格模仿、实质性近似
AIGC 很容易定向模仿特定画师、作家的个人风格。
法律难点:风格本身一般不受版权保护,版权保护的是具体表达,不是画风、文风。
风险点:如果生成结果和原作在构图、元素、细节上构成实质性相似,依然构成侵权;刻意定向复刻知名创作者风格用于商业,即便不直接复制原图,也存在不正当竞争风险。
4. 商业使用的举证难题
AIGC 生成过程是黑盒:很难追溯生成内容借鉴了哪些原始素材。一旦被控侵权,创作者很难举证模型训练用了自己的作品;厂商也很难自证输出内容没有侵权,责任划分困难。
二、伦理层面主要问题
1. 对创作者生态的冲击
短期看,AIGC 大幅降低内容生产门槛,海报、文案、插画、短视频脚本可以快速产出。负面冲击:低端外包、基础美工、流水线文案岗位被替代;新人创作者依靠接单变现的通道收窄;大量低质、同质化内容泛滥,稀释优质原创内容流量。辩证视角:AIGC 也可以作为创作者辅助工具,做草图、素材、灵感初稿;分化在于:只会执行基础任务的人容易被替代,懂得把控创意、审美、叙事的创作者可以借助工具提效。
2. 虚假信息与深度伪造(Deepfake)
AIGC 可以轻松生成虚假图片、伪造语音、仿冒人脸视频、伪造公文、新闻截图。
用于造谣、抹黑、伪造证据、仿冒他人进行诈骗;
辨别成本越来越高,冲击信息真实性,损害个人名誉,干扰公共舆论。衍生伦理要求:生成内容的标识义务 —— 很多法规要求 AI 生成内容显著标注由 AI
生成,防止混淆。
3. 偏见、歧视与刻板印象
模型学习互联网历史数据,会继承数据里隐藏的偏见:性别、地域、种族、职业刻板印象。例如:生成高管图片默认男性、特定职业绑定固定性别、对部分群体产生负面偏向。难点:偏见很难彻底消除;单纯靠人工对齐(RLHF)只能缓解,无法根除,还可能带来另一类 “过度修正”,造成内容失真。
4. 隐私侵害风险
训练数据里可能混入未脱敏的个人照片、聊天记录、身份信息、病历。 AIGC 有可能记住并复现私人信息;也可以根据少量公开信息,合成他人肖像、声音,侵犯肖像权、隐私权。
5. 内容安全与有害生成
模型有被提示词诱导生成暴力、色情、仇恨内容、教程类有害信息的风险;同时安全护栏也会出现 “误判”,正常创作被拦截,存在审查边界的平衡难题。
6. 真实性与 “信任危机”
当图文、音视频都可以低成本伪造,社会对影像、录音这类传统证据的信任基础被动摇。这个问题不止法律问题,是社会信任层面的伦理挑战。
三、容易混淆的几个关键边界(客观辨析)
版权 ≠ 伦理:有些行为不构成版权侵权,但存在伦理争议。比如模仿画师风格,法律上风格不受版权保护,但行业普遍认为是不尊重创作者的行为。
提示词不是 “免罪金牌”:无论提示词怎么写,如果最终输出抄袭、伪造、造谣,使用者依然要承担法律责任。
开源模型和闭源模型责任不一样:闭源大厂更容易管控训练数据、输出审核;开源模型扩散之后,厂商管控能力弱,责任认定更加复杂。
四、国内外治理方向与平衡思路
数据分层治理:区分公有领域作品、授权商用作品、受版权保护作品;探索版权池、集体授权机制,模型厂商向创作者集体付费获取训练许可。
溯源与标识:AI 水印、元数据标记、内容溯源技术,强制 AI 生成内容标注。
责任分配:建立多方责任:模型开发者(训练合规、安全过滤)、平台(审核)、使用者(不能用于违法侵权用途)。
行业自律:创作行业形成公约,区分 AI 辅助创作和纯 AI 生成,尊重创作者署名、风格权益。
差异化对待:区分个人非商用、教育科研、商业大规模盈利场景,适用不同标准。
五、总结
AIGC 版权困境本质是旧版权制度建立在人类创作逻辑之上,跟不上生成式 AI 这种新型生产方式;伦理问题核心是效率便利和真实、公平、人格权益之间的冲突。它不是非黑即白:禁止 AIGC 会扼杀生产力;完全放任则会摧毁原创生态、放大虚假信息风险。目前全球治理的共识方向是:鼓励合规使用,划定红线,多方分担责任,在创新和权益保护之间寻找平衡。