ChatGPT大全的局限性在哪里?客观解读
2026-10-21
浏览量:次
一、ChatGPT(大语言模型本体)的核心局限
它本质是下一个词概率预测器,不是拥有认知、事实库、感知能力的智能,所有局限都源于这个底层机制。
1. 幻觉问题:最顽固、最核心的短板
它不 “知道” 答案,只生成通顺、符合统计规律的文本。知识空白、冷门文献、法条、案例、公式、引用时,会自信地编造不存在的文献、案例、数据、人名,行文看起来非常专业,普通人很难一眼识别OpenAI。
特点:越冷门、越需要精准溯源的领域(医学、法律、学术引用、工程参数)幻觉越容易爆发;
注意:联网搜索、高级模型可以降低幻觉,但无法根除,它依然会错误整合搜索结果。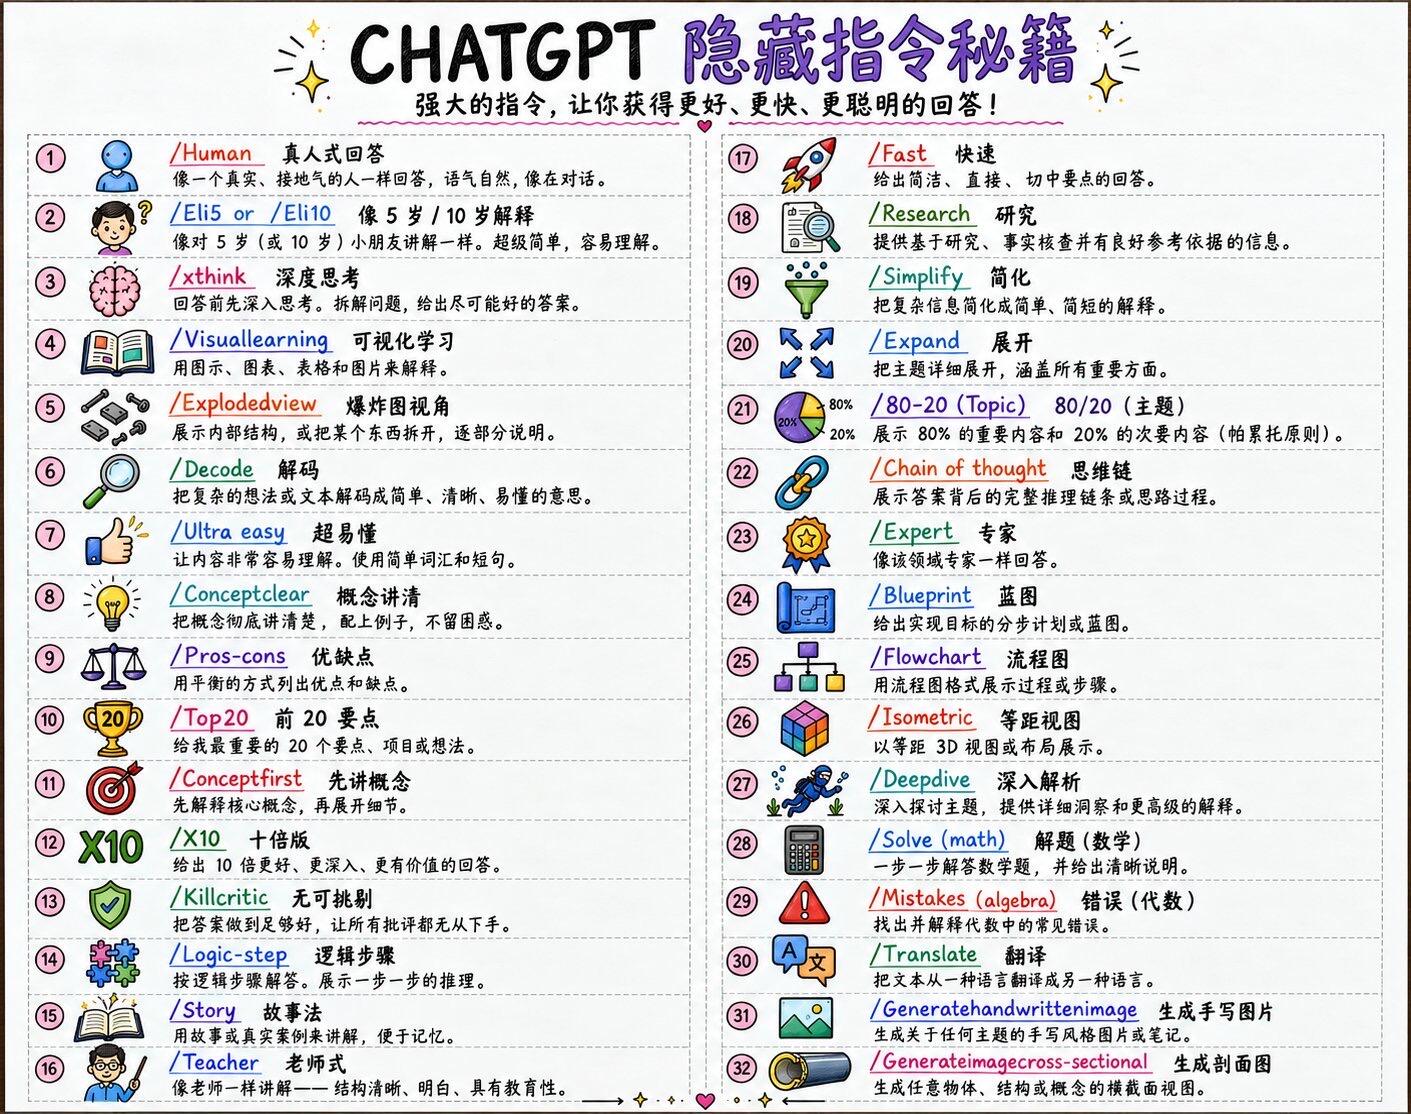
2. 知识有边界、有时间窗口
基础模型自带知识截止线,截止之后发生的事件、新规、新数据、新研究,原生模型一无所知;即使开启联网,也受搜索引擎收录、付费墙、robots 协议限制,拿不到内网、未公开、小众资料OpenAI。同时它没有现实世界持续感知能力,看不到实时画面、传感器数据、现场动态。
3. 真实推理、因果、数学与严谨工程能力不足
它擅长类比、文字推理、结构化表达,但:
容易颠倒因果、混淆相关性和因果;
复杂多步数学、符号推导、组合逻辑、长链条证明容易跳步算错;
对物理规则、真实世界约束缺少先天常识,容易输出违背现实的方案;
长文本(上万字以上)会丢失远端细节、遗忘前文约束,上下文窗口只是 “有限缓存”,不是长期记忆。
区分:它能模仿推理的表达,不等于内在建立了因果模型。
4. 偏见、价值简化、视角单一
训练数据来自互联网文本,自带社会偏见、刻板印象、主流叙事倾斜。面对有争议、多元观点的议题,经常:
把单一立场包装成标准答案;
过度简化复杂争议,抹平不同学派、不同场景下的权衡;
对齐(RLHF)会带来另一层偏向:优先输出安全、稳妥、政治合规的话术,有时回避尖锐、小众、非主流视角。
5. 没有主观意识、真实理解、原创洞见
它不会 “理解” 文字意义,没有感受、欲望、审美、亲身经验。所谓创意,是对已有文本素材重组、插值。它可以写出很漂亮的文案,但很难自发产生真正颠覆性、脱离现有文本分布的原创洞察;很容易产出套路化、同质化内容。
6. 可解释性差,黑盒特性
你很难追溯一句话来自哪条原始资料、模型为什么选这个结论。它不给你确定性的证据链,只给结论;出错之后,也很难稳定复现错误路径、定位根源,不利于高风险场景审计计算机研究...。
7. 安全、隐私与合规风险
输入敏感信息(合同、病历、企业机密)会存在数据泄露风险,不同订阅模式的数据留存规则不一样;
容易被诱导绕过安全护栏;也会过度拦截一些正常提问,出现误杀;
输出不能直接用于高风险决策:诊疗、司法意见、金融交易、特种设备操作,都必须由专业人员复核。
二、如果指【网上流传的 “ChatGPT 提示词大全”】(指令合集)的局限性
很多人买 / 收藏的 “ChatGPT 大全”,本质是一堆写好的 Prompt 模板,它的局限是另外一套:
场景强依赖,很难通用 同一个提示词,换模型版本、换问题细节、换行业,效果可能断崖下滑。模板是为某一类问题拟合出来的,不是万能公式。
容易固化思维 依赖现成提示词大全,使用者会减少自己拆解需求、定义目标的能力;很多人以为套上高级指令就等于拿到准确答案,放松事实核验。
版本滞后 OpenAI 持续迭代模型能力、指令遵循风格,老提示词大全经常在新版模型上失效;很多合集本身就是 AI 生成,里面提示词互相抄袭、质量参差不齐。
掩盖了模型本身的底层缺陷 再好的提示词,也解决不了幻觉、知识截止、因果推理缺陷。提示词只能引导输出格式、语气、思考范式,不能把概率生成器变成事实数据库。
- 上一篇:2026年B轮市场展望
- 下一篇:AIGC技术的版权与伦理问题探讨
相关文章
-
ChatGPT式如何赋能千行百业?
10-28
-
ChatGPT应用最新版本发布,性能大幅提升
10-27
-
ChatGPT平台最新版本发布,性能大幅提升
10-26
-
ChatGPT市场的局限性在哪里?客观解读
10-24
-
ChatGPT展望训练与推理成本深度分析
10-23