ChatGPT展望训练与推理成本深度分析
2026-10-23
浏览量:次
ChatGPT 展望训练与推理成本深度分析
核心结论:训练属于一次性、可分期摊销的大额固定投入,推理是持续产生、随调用规模同步增长的可变成本;模型大规模商用之后,推理支出通常会占到总算力成本七成以上,也是决定业务盈亏的核心变量。OpenAI
没有对外披露精确的内部成本数据,文中所有数值都来自第三方机构估算与行业推演,API
标价里面包含研发、集群冗余、带宽、人力、风险溢价以及利润,不等于底层裸算力成本。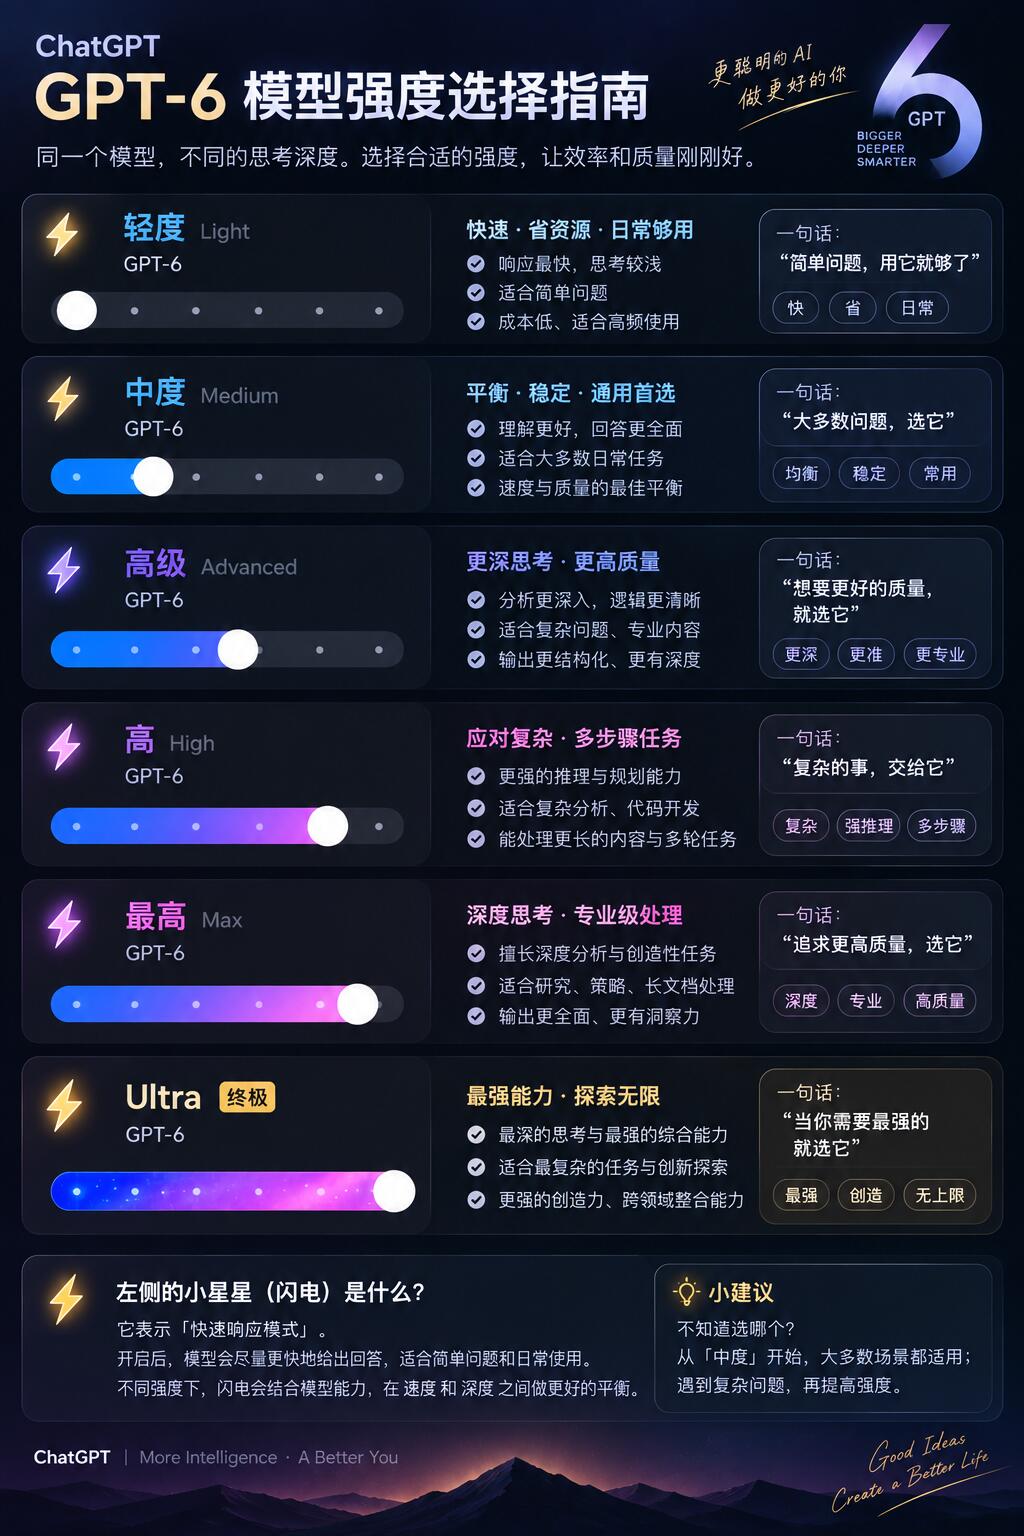
一、训练成本拆解
训练成本里最大的部分是算力,占比大约在百分之七十五到八十五之间。预训练以 BF16 或者 FP16 精度下的大矩阵运算为主,需要大量 GPU 长时间不间断运行。行业估算 GPT-3 的训练算力成本约一百四十万美元,GPT-4 训练算力估算区间在四千五百万到八千万美元;GPT-5 相关测算口径差异更大,有测算显示算力投入可达三十亿美元,数据与 RLHF 相关人力投入约十八亿美元,覆盖 SFT、偏好对齐、强化学习和人工标注等环节。
第二块是数据成本,占比百分之十到十五。包含网页原始文本清洗、版权书籍论文授权采购、高质量标注数据集、合成数据制作以及 RLHF 阶段的偏好对比标注。对齐阶段的人工标注成本十分高昂,价值不在于原始文本素材,而在于经过筛选对比的人类偏好样本。
第三块是人力与研发投入,占比百分之五到十。涵盖算法研发、集群工程团队、安全评估、大量对照实验、断点回滚、多版本验证。大模型训练很少一次跑通,大量算力消耗在试错和消融实验上。除此之外还有配套基建开销,机房供电、液冷散热、节点间高速互联、存储和带宽都会带来额外成本,NVLink、InfiniBand 这类高速通信架构,会进一步抬高有效训练成本。
训练的经济学特征十分清晰,属于前置大额投入,需要在模型整个生命周期里慢慢摊销。同时模型迭代节奏不断加快,很多前沿模型还没有完成训练投入摊销,下一代模型就已经上线,折旧压力持续走高。算力带来的能力增益是非线性的,行业已经不再单纯追求参数规模扩张,转向依靠高质量数据、MoE 稀疏架构、精细化对齐和长上下文优化,提升单位算力对应的模型能力。基座预训练只是基础,后续 SFT、DPO、多模态对齐、安全微调整套流程,在训练相关成本里的权重持续上升。同等算力投入下,继续扩大参数带来的效果提升会逐步进入边际递减区间。
训练端降本的路径主要有几个方向:通过数据筛选和数据裁剪过滤低质量样本,搭配合成数据替代海量爬虫文本,减少无效算力浪费;用 DPO 这类对齐方案替代传统 RLHF,降低人工标注依赖;采用 MoE 混合专家架构,推理时只激活部分专家模块,降低单次计算量;优化并行策略、断点保存机制、混合精度训练方案;自研训练芯片和更高效率的集群互联架构。
二、推理成本拆解(当前最大痛点)
推理分为两个阶段,资源瓶颈完全不一样。Prefill 阶段是对用户输入提示词做编码,属于并行计算,瓶颈在算力;Decode 阶段是逐 token 自回归生成内容,属于串行过程,瓶颈是显存带宽和 KV 缓存,这也是对话场景下成本消耗最高的环节,输出 token 单价普遍高于输入 token,根源就在这里。
推理成本的首要组成是 GPU 算力与显存开销,KV 缓存是推理成本最主要的来源,上下文越长,显存占用会快速上涨。其次是集群调度带来的隐性开销,负载不均衡、长尾零散请求、服务冷启动、队列等待、预留冗余机群都会拉低利用率。还有 KV 缓存的分层存储与迁移成本,现在主流方案是显存、内存、SSD 三级缓存调度,输入缓存复用机制,也是 OpenAI 能够推出缓存低价的底层原因。电力、散热、网络带宽决定集群基础开销,大规模集群的 PUE 会直接抬升单 token 成本。为保障服务稳定可用,推理集群不能跑满负载,必须预留冗余资源。除此之外还有超时重试、安全内容过滤、多轮对话状态维护这类不容易量化的隐性成本。
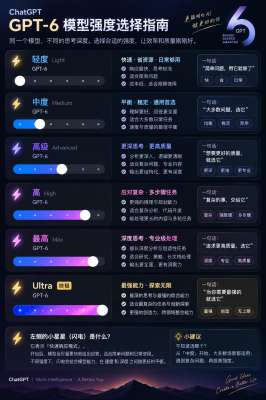
参考 OpenAI 对外公开的 API 定价区间,单位为美元每百万 token,轻量化主力模型输入约零点二美元,输出一点二美元;中端模型输入两美元,输出十二美元;高端旗舰模型输入四美元,输出二十美元;最高规格模型输入十美元,输出五十美元。API 标价远低于实际给用户的售价,同时显著高于底层裸算力成本,裸算力成本通常只有 API 定价的五分之一到十五分之一。
推理降本是当下行业竞争的主战场,核心技术方向集中在这几块。KV 缓存优化,包含滑动窗口、KV 量化压缩、PageAttention、三级缓存、输入上下文复用;稀疏与动态路由,依靠 MoE 推理、动态激活,简单请求自动分流到小模型;推测解码,用小模型先行生成草稿,大模型只负责校验,减少大模型解码步数;量化技术,FP8、MXFP4、INT4 低精度推理落地;连续批处理调度,解决传统静态批在对话场景利用率偏低的问题;面向推理场景的专用芯片,不再照搬训练芯片的设计思路,优先优化显存带宽和 KV 读写效率;任务级优化,结构化选择类任务不再生成自由文本,改变传统按 token 计费的逻辑。
三、训练与推理的经济学对比
训练环节以并行矩阵运算为主,瓶颈集中在算力层面;推理分成两段,Prefill 吃算力,Decode 受限于显存带宽。训练成本属于前置固定投入,依靠长期摊销回本;推理是可变成本,调用量越高,开销同步上涨。两者都具备规模效应,训练规模上来之后单次试跑的单位成本下降,但失败试错的沉没成本很高;推理的规模效应更强,整体吞吐越高,单 token 成本越低,零散的长尾请求单位成本会明显偏高。在模型上线初期,训练是成本主体,等到大规模商用之后,推理算力支出会占到七成到八成以上。训练优化重点围绕数据质量、对齐方案、并行框架、MoE 结构;推理优化聚焦 KV 缓存、调度批处理、推测解码、专用推理芯片。训练对应的风险集中在训练失败、能力不及预期、数据集污染;推理侧风险更多来自流量突增、长尾请求、超长上下文带来的账单失控。
一个很典型的行业事实,GPT-4 训练成本估算约七千八百万美元,在高用户体量的情况下,大约四个月产生的推理账单就可以超过前期全部训练投入。
四、行业趋势展望
成本曲线会走出两条分化路线。面向复杂任务的旗舰模型,单 token 价格下降速度偏慢,但单位任务成本持续优化,核心逻辑是模型能力变强,完成相同目标所消耗的 token 轮次变少,依靠减少 token 消耗实现降本,而不是直接压低单价。面向日常对话、检索、简单智能体的轻量化模型,价格会持续下探,未来有机会降到每百万 token 零点一美元以内,持续替代传统搜索、客服和基础文本生成业务。
计价范式正在从单纯按 token 计费,慢慢转向按任务计费。当前 token 计价本质是底层算力的映射,缺陷是用户很难锁定总开销,长思考、长输出很容易造成费用不可控。OpenAI 已经在尝试多种新模式,包括输入缓存折扣、结构化输出不计费的 Decisions 接口,还有多档位推理强度选项,同一个模型可以按需选择算力投入强度,成本不再一刀切。未来智能体场景,打包按会话、按工作流定价会越来越普遍。
硬件架构走向分层,训练芯片和推理芯片设计目标彻底分开。训练芯片优先追求算力和节点互联带宽;推理芯片优先优化显存带宽、低精度运算、KV 缓存读写和能效。异构集群会成为主流,通用 GPU 负责 Prefill 和高难度推理任务,自研 ASIC 芯片承接常规解码任务。
成本端长期约束同样不可忽视。高质量可商用文本数据供给逐渐见底,原始互联网数据红利消退,虽然合成数据可以补充供给,但存在分布偏移的隐患,长期会抬升下一代模型训练的门槛。大规模集群扩张还要受到电力、冷却、土地资源的物理约束,无限堆算力的路线不可持续。行业持续价格内卷,API 毛利不断压缩,倒逼厂商把资源倾斜到推理效率工程优化上。智能体应用天然是多步骤链式调用,伴随工具调用和长上下文,单任务 token 消耗远高于普通对话,如果缺少缓存、路由、子任务拆分能力,智能体商业化很容易被推理成本限制。
中长期格局可以做几点预判。训练成本不会无上限暴涨,行业已经从参数竞赛转向效率竞赛,同等能力下训练算力需求增速放缓。接下来五年,推理基础设施是行业竞争的核心战场,能够把推理 GPU 利用率从百分之二十到三十提升至百分之六十以上的厂商,会拿到显著的成本优势。分层服务格局会固化,简单问答交给低成本小模型,复杂数学、代码、智能体规划调用高规格旗舰模型,由路由系统自动分流调度。私有化推理成本持续下行,企业客户普遍会采用混合方案,API 承接峰值流量和复杂任务,本地小模型承载高频简单对话,控制整体账单规模。
五、对商业模式的启示
ChatGPT 这类生成式产品,毛利率上限由推理效率决定,而不是训练成本。训练更像一笔一次性的长期研发投入。在产品设计层面,主动控制 token 消耗是比单纯降价更有效的盈利手段,比如上下文自动摘要裁剪、对话历史缓存、简单请求路由到轻量模型。只对比 API 单价参考意义有限,更有价值的指标是单位任务成本,同样完成一项需求,一个模型输出三百 token,另一个只需要八十 token,哪怕后者单 token 定价更高,整体开销反而更低。
- 上一篇:C端市场的全球化竞争策略
- 下一篇:AIGC报告正在改变内容创作方式
相关文章
-
ChatGPT式如何赋能千行百业?
10-28
-
ChatGPT应用最新版本发布,性能大幅提升
10-27
-
ChatGPT平台最新版本发布,性能大幅提升
10-26
-
ChatGPT市场的局限性在哪里?客观解读
10-24
-
ChatGPT展望训练与推理成本深度分析
10-23