深度解析:Kubernetes的背后逻辑
2026-11-20
浏览量:次
### 深度解析:Kubernetes的背后逻辑
在云原生时代的浩瀚星空中,Kubernetes(简称K8s)无疑是那颗最耀眼的恒星。它不仅仅是一个开源的容器编排引擎,更是一套关于分布式系统管理的哲学与标准。从最初的Google
Borg系统演变而来,Kubernetes之所以能击败Docker
Swarm等竞争对手,成为事实上的行业标准,并非仅因其功能强大,更在于其背后深邃的设计逻辑:一种基于“声明式API”与“控制器模式”构建的、追求“最终一致性”的自动化治理体系。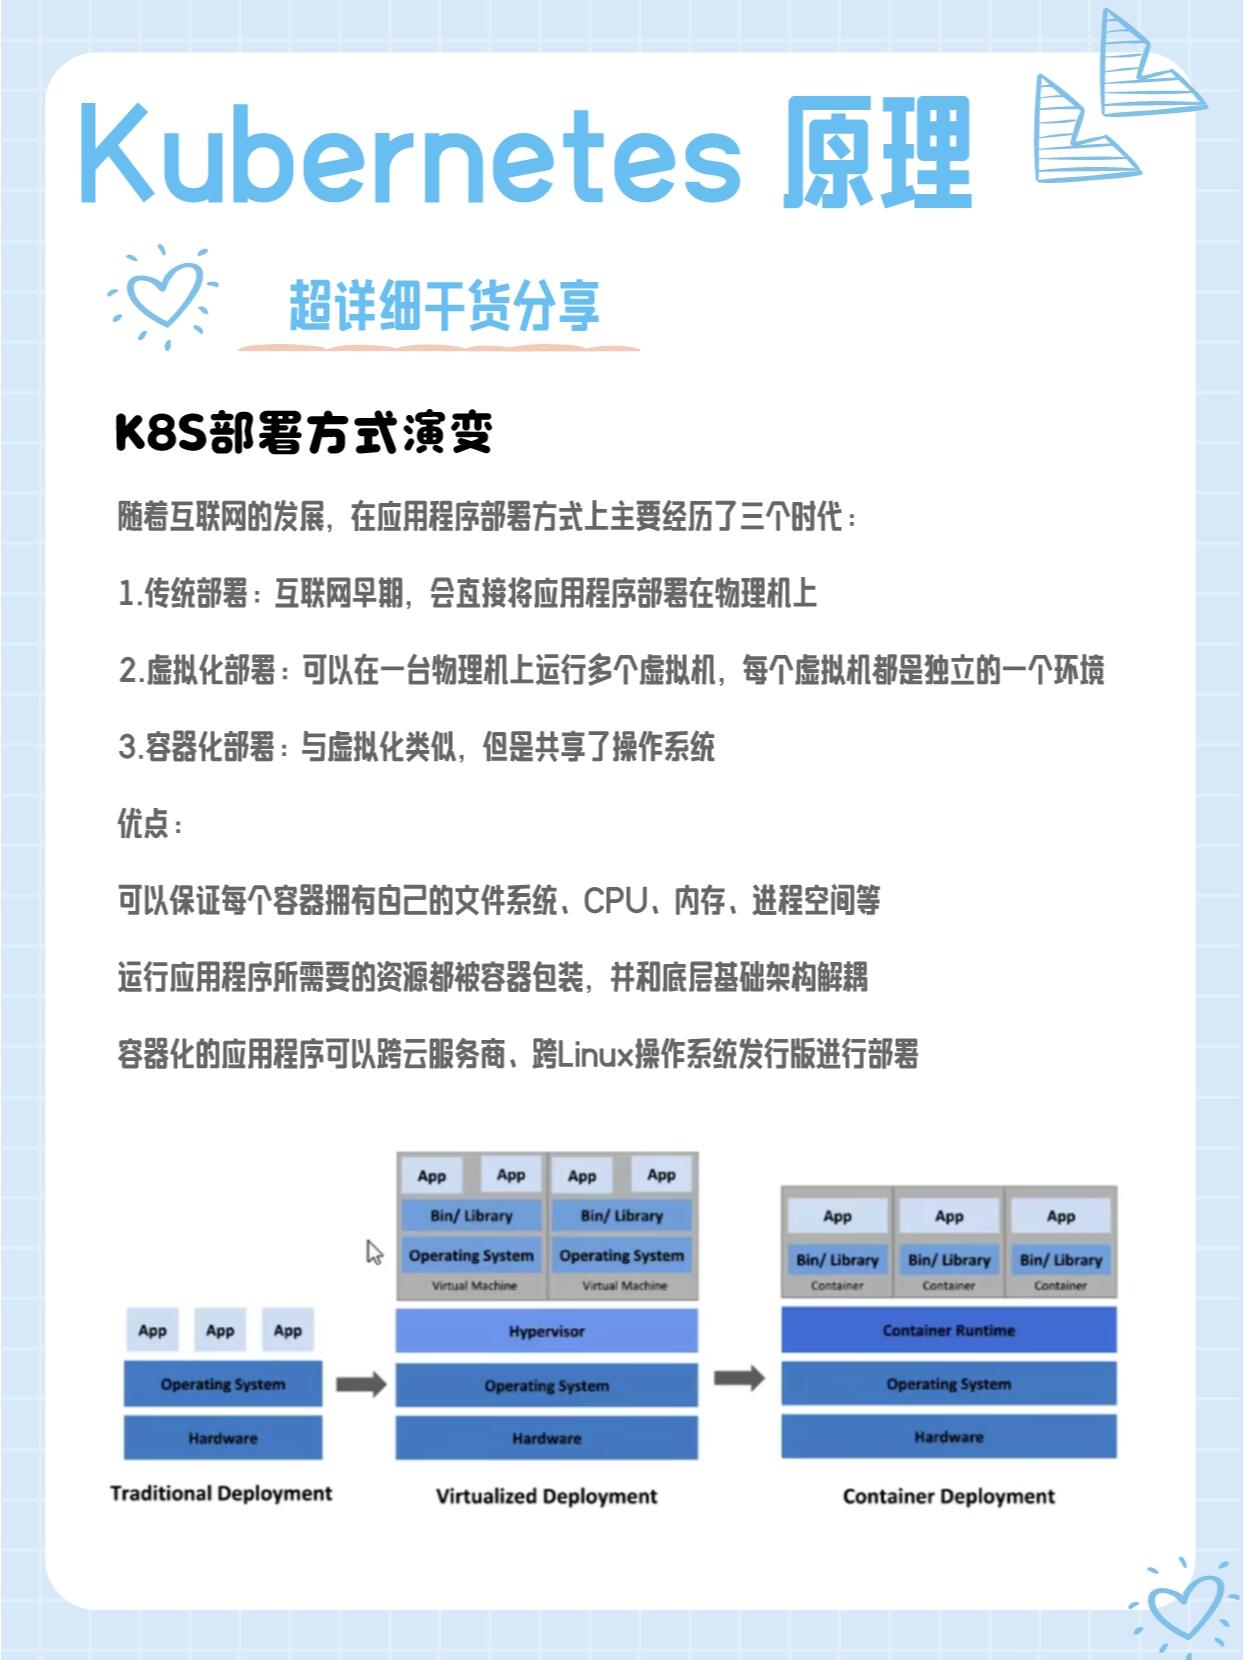
#### 一、 核心哲学:声明式API与“单一事实来源”
理解Kubernetes的逻辑,首先要打破传统运维“命令式”的思维定势。在传统模式下,我们告诉系统“做什么”(例如:启动一个容器);而在Kubernetes的世界里,我们告诉系统“要什么”(例如:保持有三个容器在运行)。
这就是**声明式API**的魅力。用户通过YAML文件向Kubernetes的API Server提交一个期望状态(Desired State)。这个状态被持久化存储在**etcd**中。etcd是一个基于Raft一致性算法的高可用键值存储数据库,它是整个集群的“单一事实来源”(Source of Truth)。无论集群发生何种故障,etcd中存储的数据永远代表着集群“应该”呈现的样子。这种设计将“意图”与“执行”彻底解耦,使得系统具备了极强的容错能力和可恢复性。
#### 二、 运行引擎:控制器模式与“控制回路”
如果说etcd是大脑记忆,那么**控制器模式**就是Kubernetes的神经系统。Kubernetes内部运行着各种各样的控制器(如ReplicaSet Controller、Deployment Controller),它们遵循一个经典的控制回路逻辑:**观察 -> 分析 -> 行动**。
控制器会持续不断地通过API Server监听(Watch)集群的实际状态。一旦发现实际状态与etcd中的期望状态不一致(例如,期望3个副本,实际只有2个),控制器就会立即触发调节机制,调用底层组件去创建或销毁资源,直到两者重新达成一致。这种机制赋予了Kubernetes强大的**自愈能力**——当某个节点宕机,控制器会感知到Pod失联,并自动在其他健康节点上重新调度新的Pod,无需人工干预。
#### 三、 架构解耦:主从协同与插件化生态
在架构层面,Kubernetes采用了清晰的**控制平面与数据平面**分离的设计。
控制平面(Master节点)是集群的大脑,负责全局决策。其中,**API Server**是所有交互的唯一入口,不仅处理REST请求,还负责认证与鉴权;**调度器**则像一位精明的物流调度员,根据资源需求和亲和性规则,将Pod分配到最合适的节点上。
数据平面(Worker节点)则是干苦力的肌肉。**Kubelet**作为节点代理,接收指令并指挥容器运行时(如containerd)启动容器;**Kube-Proxy**则负责维护网络规则,实现服务发现与负载均衡。
更为高明的是其**插件化设计**。Kubernetes深知自己无法满足所有场景,因此通过CNI(容器网络接口)、CSI(容器存储接口)和CRI(容器运行时接口)将网络、存储和运行时标准化。这意味着用户可以像搭积木一样,根据业务需求替换底层的具体实现(如将网络从Flannel换成Calico),而无需改动核心代码。
#### 四、 终极形态:从编排到平台
Kubernetes的背后逻辑,本质上是对复杂度的封装。它通过**自定义资源定义**和**Operator模式**,允许开发者将特定应用(如数据库)的运维知识编码化。这使得Kubernetes从一个单纯的容器编排工具,进化为一个能够管理任意复杂有状态应用的“云操作系统”。
综上所述,Kubernetes的成功并非偶然。它用“声明式”简化了交互,用“控制器”实现了自动化,用“解耦架构”保证了扩展性。在2026年的今天,理解Kubernetes,就是理解分布式系统治理的最高智慧。
- 上一篇:专家信息安全技术栈选型指南
- 下一篇:从专家科技公司看科技产业投资逻辑
相关文章
-
深度解析:Kubernetes的背后逻辑
11-20
-
最新动态:Kafka值得关注
11-19
-
深度解析:K8s的背后逻辑
11-18
-
深度解析:Jenkins的背后逻辑
11-17
-
最新动态:Istio值得关注
11-16