HPA全面解读
2026-11-10
浏览量:次
HPA 全面解读(K8s HPA,云原生 / AI 算力场景,适配你前面 AI 芯片、大模型算力汇报)
一句话总纲:HPA 全称 Horizontal Pod Autoscaler,K8s 原生水平自动扩缩控制器;负载上来就增加 Pod 副本、负载下降自动减少副本,用来弹性调度算力,是大模型推理、在线服务降本、削峰填谷的核心组件Kubernetes。
区分:水平扩容 = 加实例;垂直扩容 = 给单个 Pod 升级 CPU / 显存;HPA 只管水平扩缩。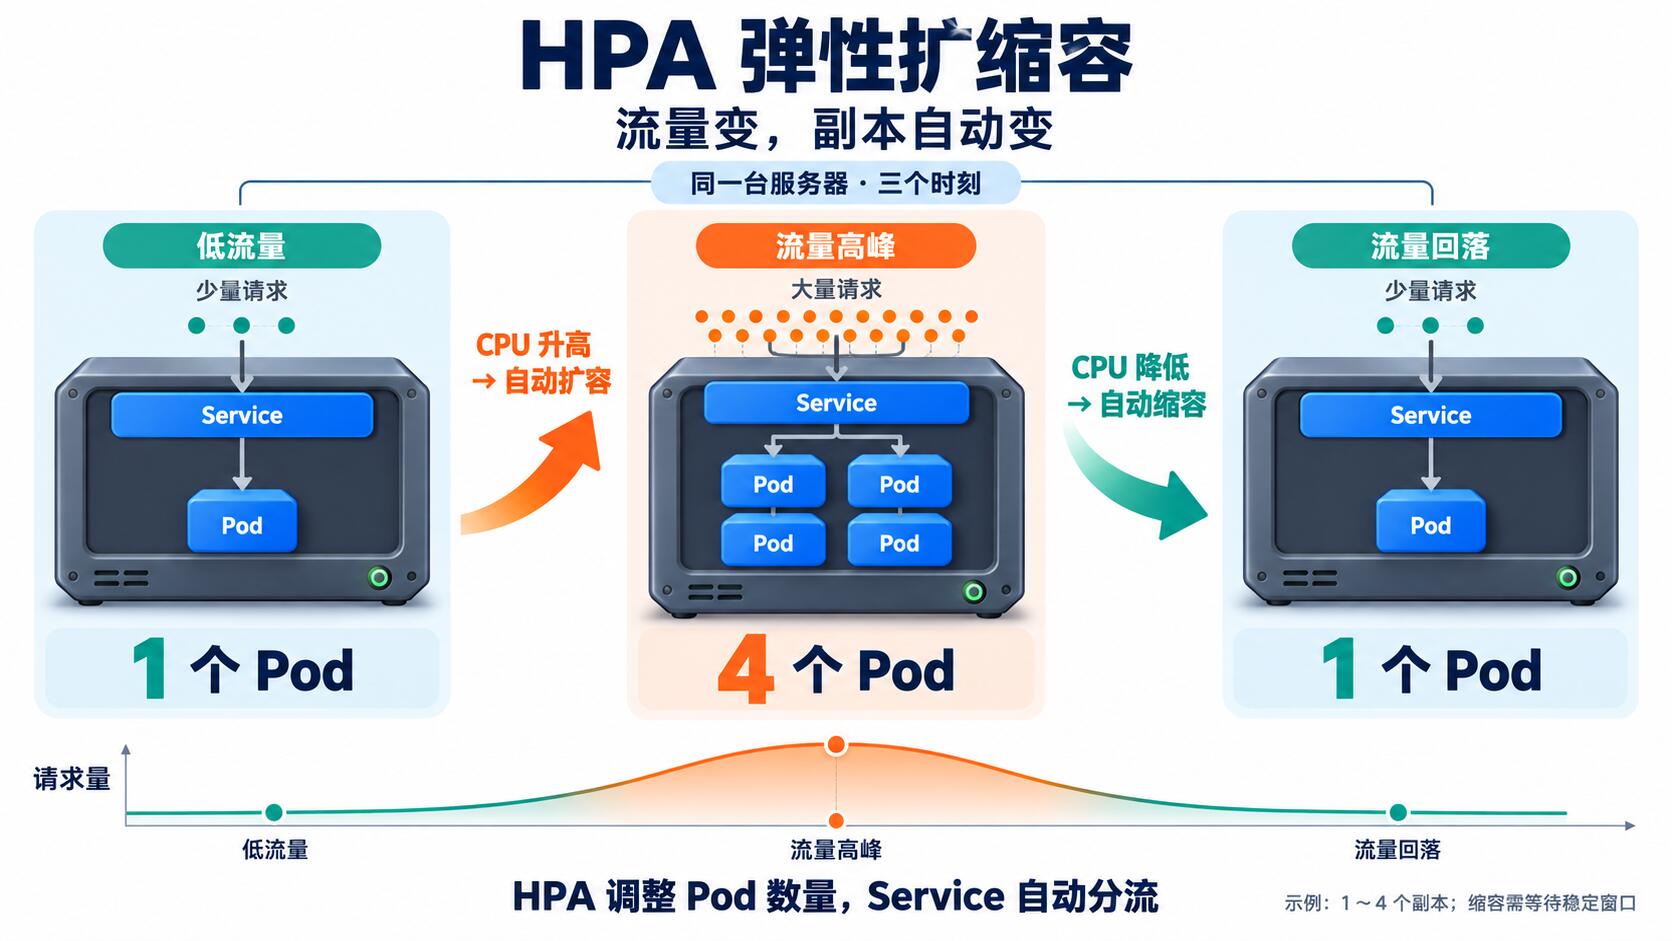
一、基础原理
HPA 是 K8s 的一个持续循环控制器,默认每 15 秒一轮采集指标,算目标副本数,下发给 Deployment/StatefulSet 调整实例数量,DaemonSet 不支持 HPAKubernetes。核心计算公式:
期望副本数 = ceil (当前副本数 × 当前指标值 ÷ 目标阈值)
举例:目标 CPU 利用率 70%,当前 2 个 Pod,CPU 跑到 90% 期望副本 = 2 × 90% ÷70% ≈ 2.57 → 向上取整 = 3 个 Pod。
指标分两大类:
内置资源指标(原生):CPU 利用率、内存使用率;传统 Web 服务最常用
自定义指标(AI 推理必备):GPU 利用率、显存占用、队列长度、请求延迟、QPS,对接 Prometheus、自定义 Exporter 采集 NPU/GPU 指标
二、核心配置参数
minReplicas:最小副本,最低保底实例,防止流量为 0 直接缩到 0
maxReplicas:最大副本,算力上限,防止突增流量打爆集群、超预算
target:目标指标阈值(例如 GPU 使用率 70%)
behavior(v2 版本):扩缩容防抖策略
扩容:快速扩容,应对突发流量;
缩容:稳定窗口(冷却时间),默认 5 分钟,防止指标抖动、频繁反复扩缩(震荡)
容忍度 tolerance:指标小幅波动忽略,避免频繁触发
三、在 AI 算力 / 大模型场景的痛点(重点,汇报必讲)
普通 Web 服务:CPU 负载和请求量强相关,原生 HPA 很好用; GPU / 大模型推理场景,原生 HPA 很容易失灵:
模型加载进显存之后,显存长期占用,哪怕没请求,显存指标居高不下;
GPU 利用率是脉冲式,来一批请求瞬间拉满,空闲时直接归零;
指标和真实排队请求量脱节,看 GPU 使用率扩容容易滞后或者误扩容。
✅ 行业主流解决方案:
不用 GPU 使用率做触发,改用推理队列深度、待处理请求数作为扩容信号;
搭配 KEDA(Kubernetes Event-Driven Autoscaling),KEDA 支持消息队列、redis、自定义指标,支持缩到 0,GPU 闲置时释放昂贵算力,是 AI 推理集群标配;
分层预热:HPA 负责弹性扩容,提前加载模型,规避冷启动超长延迟。
四、HPA vs KEDA(对比)
HPA:K8s 原生,只能基于指标扩缩;不支持缩到 0;适合常规在线业务;
KEDA:扩展组件,支持消息队列、触发器、定时扩缩;支持 scale to zero;AI 推理、异步任务、离线批量推理首选。
五、典型落地流程(大模型推理集群)
推理服务打包成容器,部署 Deployment;
部署 GPU 监控 Exporter,采集 NPU/GPU 利用率、显存、推理队列;
配置 HPA(或 KEDA),以队列深度作为核心指标;
设置 min 副本保底,保证基础流量可用;max 副本控制算力成本;
配置缩容冷却窗口,避免流量抖动反复启停;
配合负载均衡,流量自动分发到新增推理 Pod。
六、优势、风险与边界
价值
削峰填谷:高峰期自动拉起更多推理实例,保障时延;低峰自动释放 GPU,节省算力成本;
自动化运维,不用人工盯着流量手动改副本;
适配混合算力集群:GPU、NPU 昇腾、寒武纪等 AI 加速卡都可以接入。
局限 & 风险
只扩 Pod,不能自动拆分大模型;模型本身太大,单 Pod 无法拆分时,HPA 无能为力;
扩容有延迟:调度、拉镜像、加载模型,大模型冷启动几十秒到几分钟;
指标选错会造成资源浪费或者雪崩;
不适合训练任务:训练任务大多是长驻、固定资源,很少用 HPA 弹性。
- 上一篇:SOC形势日益严峻,如何应对?
- 下一篇:三星巨头财报解读与战略分析
相关文章
-
深度解析:Kubernetes的背后逻辑
11-20
-
最新动态:Kafka值得关注
11-19
-
深度解析:K8s的背后逻辑
11-18
-
深度解析:Jenkins的背后逻辑
11-17
-
最新动态:Istio值得关注
11-16