实测体验:AIGC调研到底有多强?
2026-11-12
浏览量:次
#### 实测体验:AIGC调研到底有多强?
站在2026年的时间节点回望,AIGC早已褪去了2023年时的青涩与狂热,从单纯的“聊天玩具”进化为数字世界的底层操作系统。然而,当企业决策者和内容创作者试图从海量的工具中淘金时,一个新的疑问随之浮现:这些标榜着“智能”的AIGC调研与检测工具,到底有多少真本事?为了探寻答案,我们进行了一场跨越生成、检测与应用的深度实测。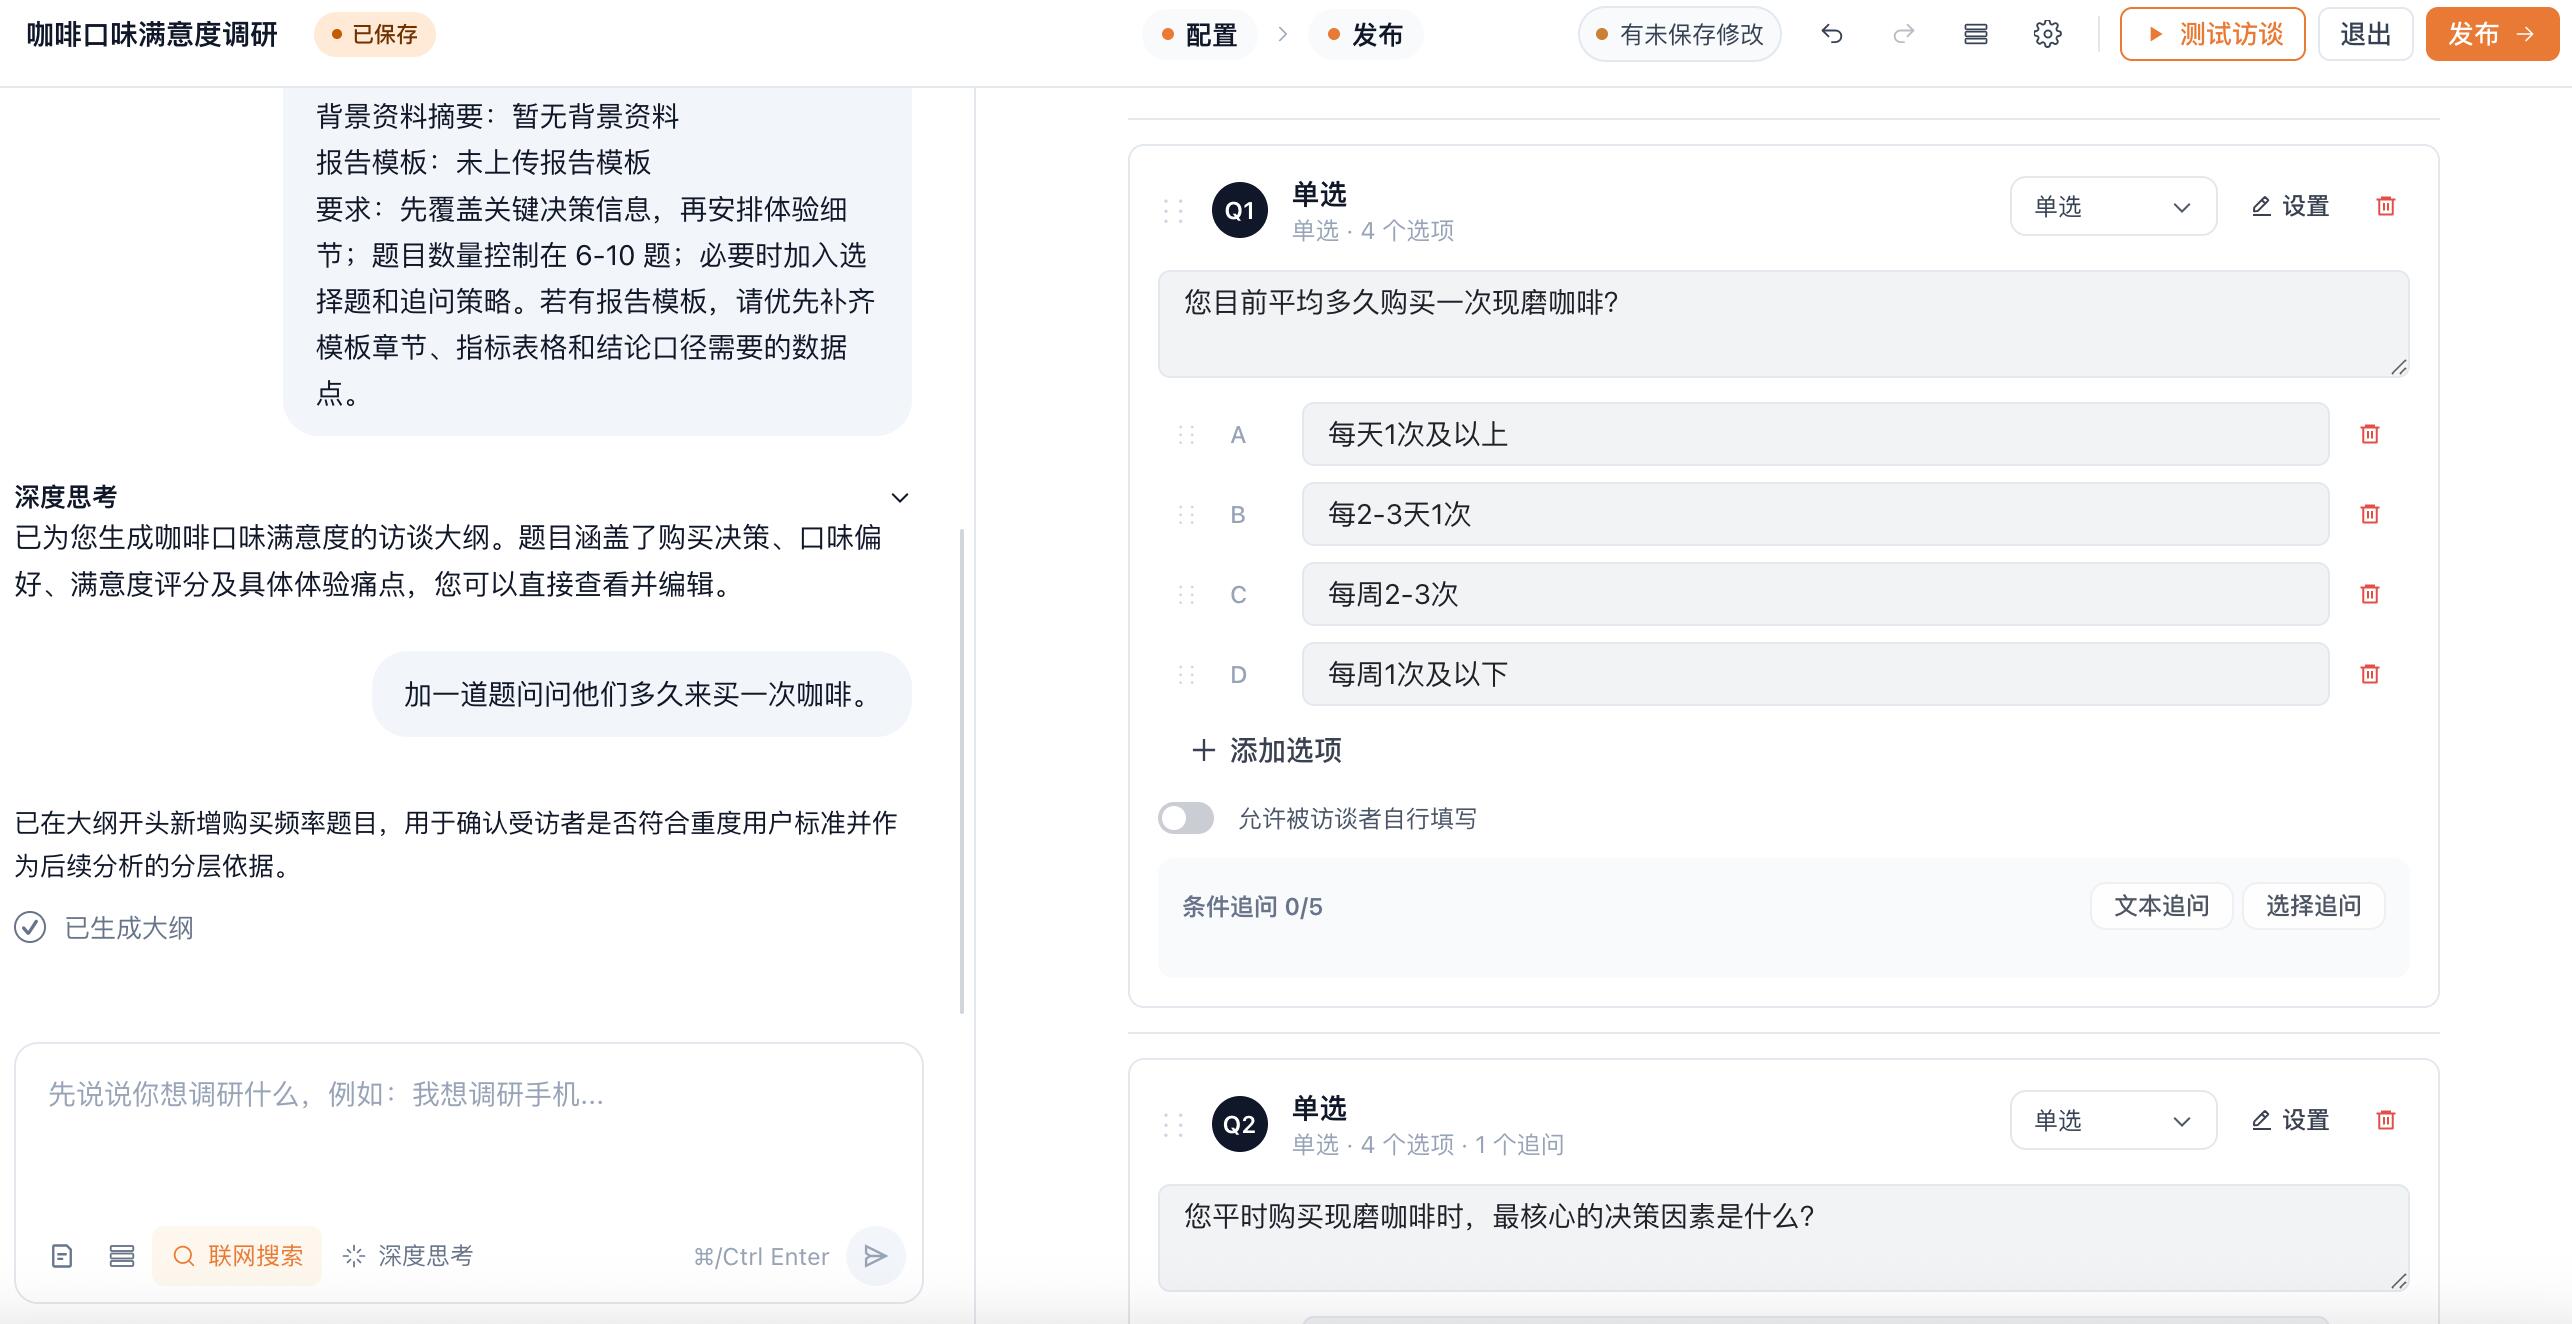
**生成侧:从“能用”到“好用”的智商分层**
调研的第一步,是评估“生产力”。我们将市面上主流的对话式AIGC应用置于同一套评估体系下,涵盖了逻辑推理、创意写作、数学计算及情商问答等23个细分指标。实测结果显示,AI的“智商”已出现明显的分层与专业化趋势。
在处理复杂的逻辑推理和多轮行程规划时,文心一言展现出了极强的统筹能力,它像一位经验丰富的老管家,能妥善处理错综复杂的约束条件;而通义千问则在创意写作领域拔得头筹,其文字的温度与想象力更符合文学创作的直觉。更有趣的是,在硬核的数学计算与专业知识问答上,讯飞星火与智谱清言分别占据了高地。这告诉我们,AIGC的调研不能只看“总分”,更要看“特长”。对于企业而言,选择客服机器人还是代码助手,所需的“大脑”截然不同。
**检测侧:猫鼠游戏中的“防伪标签”**
随着生成内容的泛滥,如何鉴别“含AI量”成为了调研的重头戏。我们选取了多篇混合了人工撰写与GPT系列生成的文本进行“盲测”。在这场猫鼠游戏中,单纯的关键词匹配早已失效,真正的较量发生在统计学特征的微观层面。
实测发现,像“文件通”这类独立检测工具,在识别未经修饰的通用AI文本时准确率极高,它们能精准捕捉到机器语言中特有的“困惑度”与“突发性”特征。然而,面对经过深度润色或混合编辑的文本,误判率便会上升。更高级的博弈发生在“优彩云AI内容工厂”这类平台,它们采用了“源头治理”的策略——在内容生成的瞬间,通过算法主动调整文本的统计特征分布,使其天然接近人类写作模式。这种“自带隐身衣”的生成方式,让传统的检测工具几近失效。这揭示了一个残酷的真相:AIGC检测技术正在被生成技术反向碾压,未来的调研重点将从“事后鉴别”转向“全流程合规”。
**应用侧:落地能力的“最后一公里”**
脱离了实验室环境,AIGC在真实业务场景中的表现如何?在针对企业级应用的调研中,我们发现“工具焦虑”正在被“实效焦虑”取代。
在内容安全领域,文查通等工具将AIGC检测与违禁词筛查结合,为机构用户筑起了一道合规防线,这在《生成式人工智能服务管理暂行办法》实施的背景下显得尤为重要。而在学术与专业领域,查重与降重工具经历了从“机械替换”到“语义重写”的进化。以查直降为例,其实测数据表明,先进的工具已能在保留专业术语和逻辑框架的前提下,将AIGC率从50%以上降至10%以内,且格式保留完整。这说明,AIGC的辅助能力已不仅仅是生成,更包含了深度的“清洗”与“重塑”。
**结语**
综合来看,2026年的AIGC调研结果呈现出一种“双螺旋”上升的态势:生成能力越强,检测与治理的难度就越大。对于用户而言,AIGC不再是万能的魔法,而是一套需要精细调校的工具组。无论是选择擅长逻辑的“管家”,还是自带防伪的“工厂”,亦或是严守合规的“安检员”,认清它们的边界与特长,才是驾驭这股智能浪潮的关键。
- 上一篇:从ChatGPT生态看人工智能的能力边界
- 下一篇:AI芯片系统短缺问题何时能缓解?