从ChatGPT生态看人工智能的能力边界
2026-11-12
浏览量:次
#### 从ChatGPT生态看人工智能的能力边界
2026年的初冬,当GPT-6
Astra模型在云端向全球付费用户推送时,科技界却意外地陷入了一场关于“降智”的讨论。这并非技术的倒退,而是一次意味深长的“图灵测试”:当AI的能力边界被推至前所未有的高度,我们看到的不再是无所不能的神迹,而是它依然受制于物理法则与逻辑局限的真实轮廓。回望ChatGPT的演进生态,我们正站在一个十字路口,重新审视人工智能的能力边界究竟在哪里。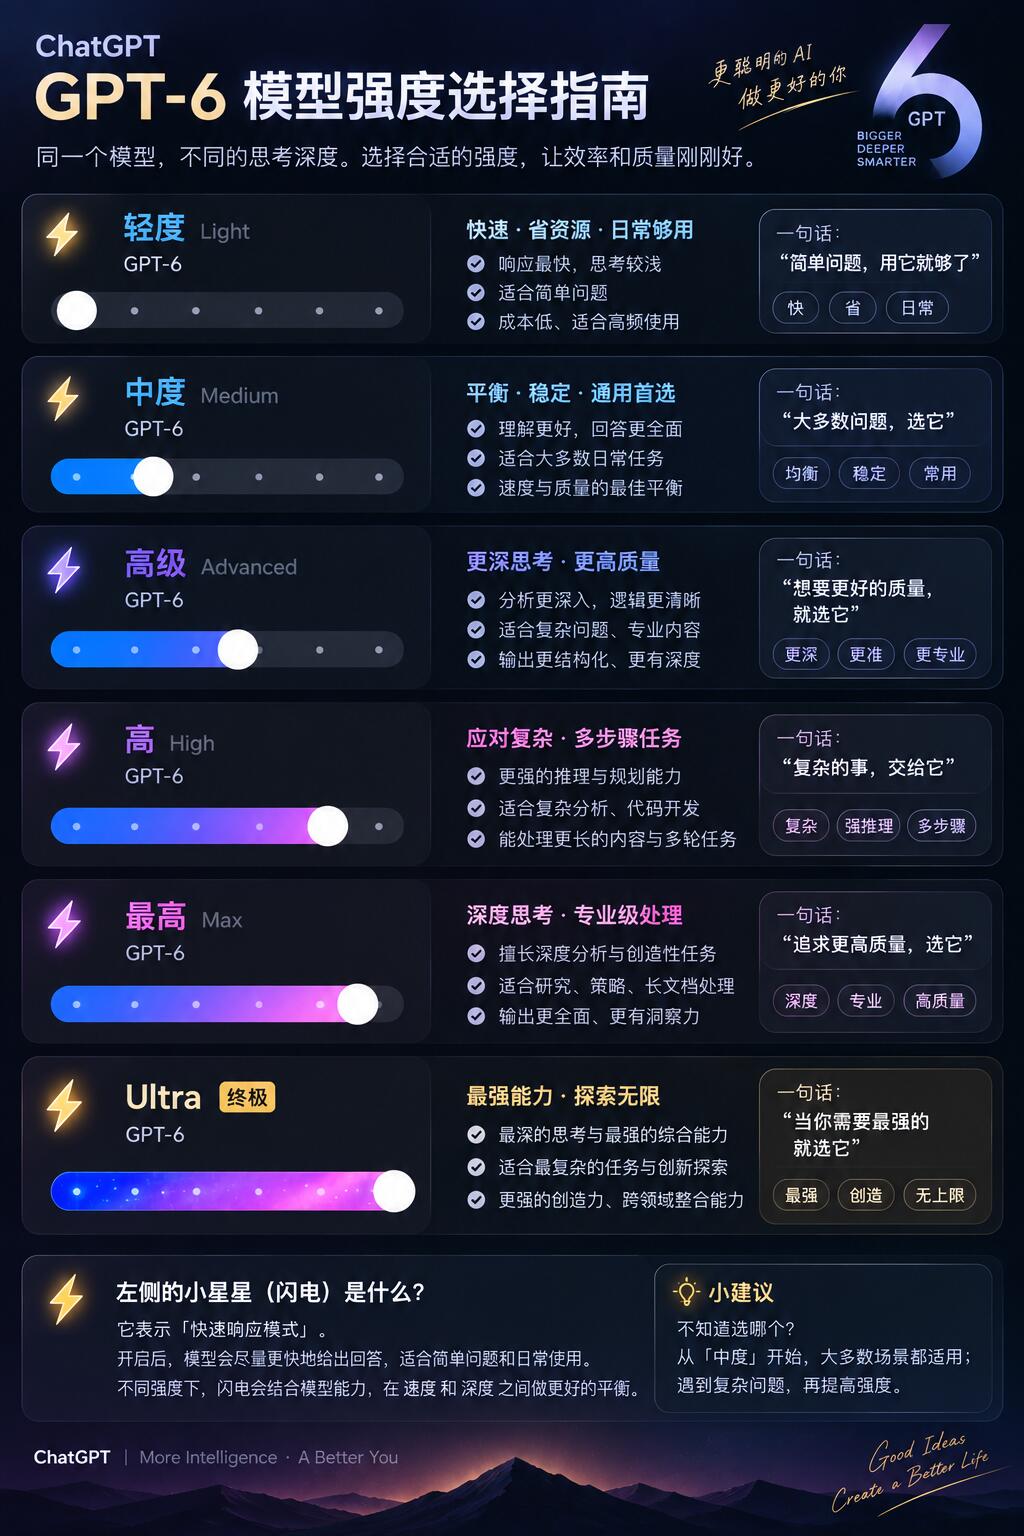
**一、 认知的边界:从“全知”到“幻觉”的博弈**
ChatGPT生态最显著的进化,是从单一的文本生成走向了智能体(Agent)的构建。2025年发布的Responses API,集成了网络搜索、文件检索乃至计算机操作能力,试图让AI拥有“手”和“眼”。然而,能力的扩张并未完全消除“幻觉”的阴影。
在2026年的“鹈鹕杯”众测中,开发者们发现,即便是最先进的模型,在面对“画一只骑自行车的鹈鹕”这样看似简单的指令时,仍会出现逻辑崩塌或物理常识错误。这揭示了AI认知的边界:它依然是在概率的海洋中冲浪,而非在真理的陆地上行走。它能模拟逻辑,却无法像人类一样真正“理解”因果。当任务复杂度呈指数级上升,如进行长周期的软件工程或科学推演时,模型的不稳定性便会暴露无遗。AI的“智力SLA”(服务等级协议)尚未达成,它依然是那个需要人类时刻在旁纠错的“博学实习生”。
**二、 物理的边界:云端智慧与端侧算力的拉锯**
ChatGPT的强大,建立在庞大的云端算力之上。然而,2026年9月OpenAI因算力供给压力暂停部分套餐订阅的事件,无情地揭示了这一边界的脆弱性。云端大模型的内卷,正在撞上物理硬件的墙。
这迫使AI能力的边界向端侧延伸。无论是微软Azure的独家托管,还是亚马逊AWS Bedrock的接入,都无法解决延迟与隐私的根本矛盾。于是,我们看到AMD锐龙AI系列处理器的崛起,以及各大厂商拼命将百亿参数模型塞进手机和笔记本的尝试。AI的能力边界,不再仅仅由算法决定,更受制于NPU的算力指标和内存带宽。当AI试图接管我们的工作流,它必须在云端“大脑”与端侧“神经”之间找到平衡。一旦脱离了这一硬件底座,再宏大的AI愿景也只是空中楼阁。
**三、 生态的边界:从“搜索”到“答案”的流量重构**
ChatGPT生态正在重塑信息的获取方式。当用户习惯从“输入框+十条链接”转向“对话框+直接答案”时,AI实际上成为了信息的守门人。这种入口的变迁,划定了AI在商业世界的边界。
目前的AI搜索查询量虽已占据传统搜索引擎的两成,但它并未创造信息,只是信息的搬运工与重组者。这带来了新的危机:当AI成为唯一的出口,品牌与内容生产者必须通过GEO(生成式引擎优化)来讨好算法,而非取悦人类。AI的能力边界在于,它能高效分发信息,却难以保证信息的源头活水不被污染。如果互联网变成了AI生成的垃圾内容互喂的闭环,那么ChatGPT生态的繁荣将建立在沙滩之上。
**结语**
从GPT-3的横空出世到GPT-6的算力瓶颈,ChatGPT生态的发展史,就是一部人类不断试探机器极限的历史。我们看清了它的能力边界:在认知上,它受困于概率与逻辑的鸿沟;在物理上,它受限于云端与端侧的算力博弈;在生态上,它面临着信息茧房的反噬。
承认边界,并非否定未来。恰恰相反,正是这些边界的存在,定义了人类在AI时代的独特价值——我们是那个在“鹈鹕”画错时按下重置键的人,是那个为AI提供物理载体的人,也是那个在算法洪流中坚守真实内容的人。人工智能的征途是星辰大海,但领航的罗盘,依然握在我们手中。
- 上一篇:一文看懂IaC
- 下一篇:实测体验:AIGC调研到底有多强?
相关文章
-
ChatGPT详解如何赋能千行百业?
11-20
-
从ChatGPT解读看人工智能的能力边界
11-19
-
ChatGPT解析对比评测,各有哪些优势?
11-18
-
ChatGPT观察训练与推理成本深度分析
11-17
-
ChatGPT行业最新版本发布,性能大幅提升
11-16