ChatGPT系统的局限性在哪里?客观解读
2026-11-13
浏览量:次
### 光环之下的阴影:客观审视ChatGPT系统的局限性
自ChatGPT横空出世以来,生成式人工智能仿佛一夜之间打破了人机交互的坚冰,以其惊人的语言组织能力和知识广度重塑了我们对“智能”的认知。然而,在惊叹于其“无所不知”的表象之下,我们必须保持一份冷静的清醒:ChatGPT并非全知全能的神谕,它依然是一个基于概率统计的数学模型。要真正驾驭这一工具,就必须客观地审视其内在的局限性,理解它在事实准确性、逻辑推理、时效性以及伦理安全边界上的短板。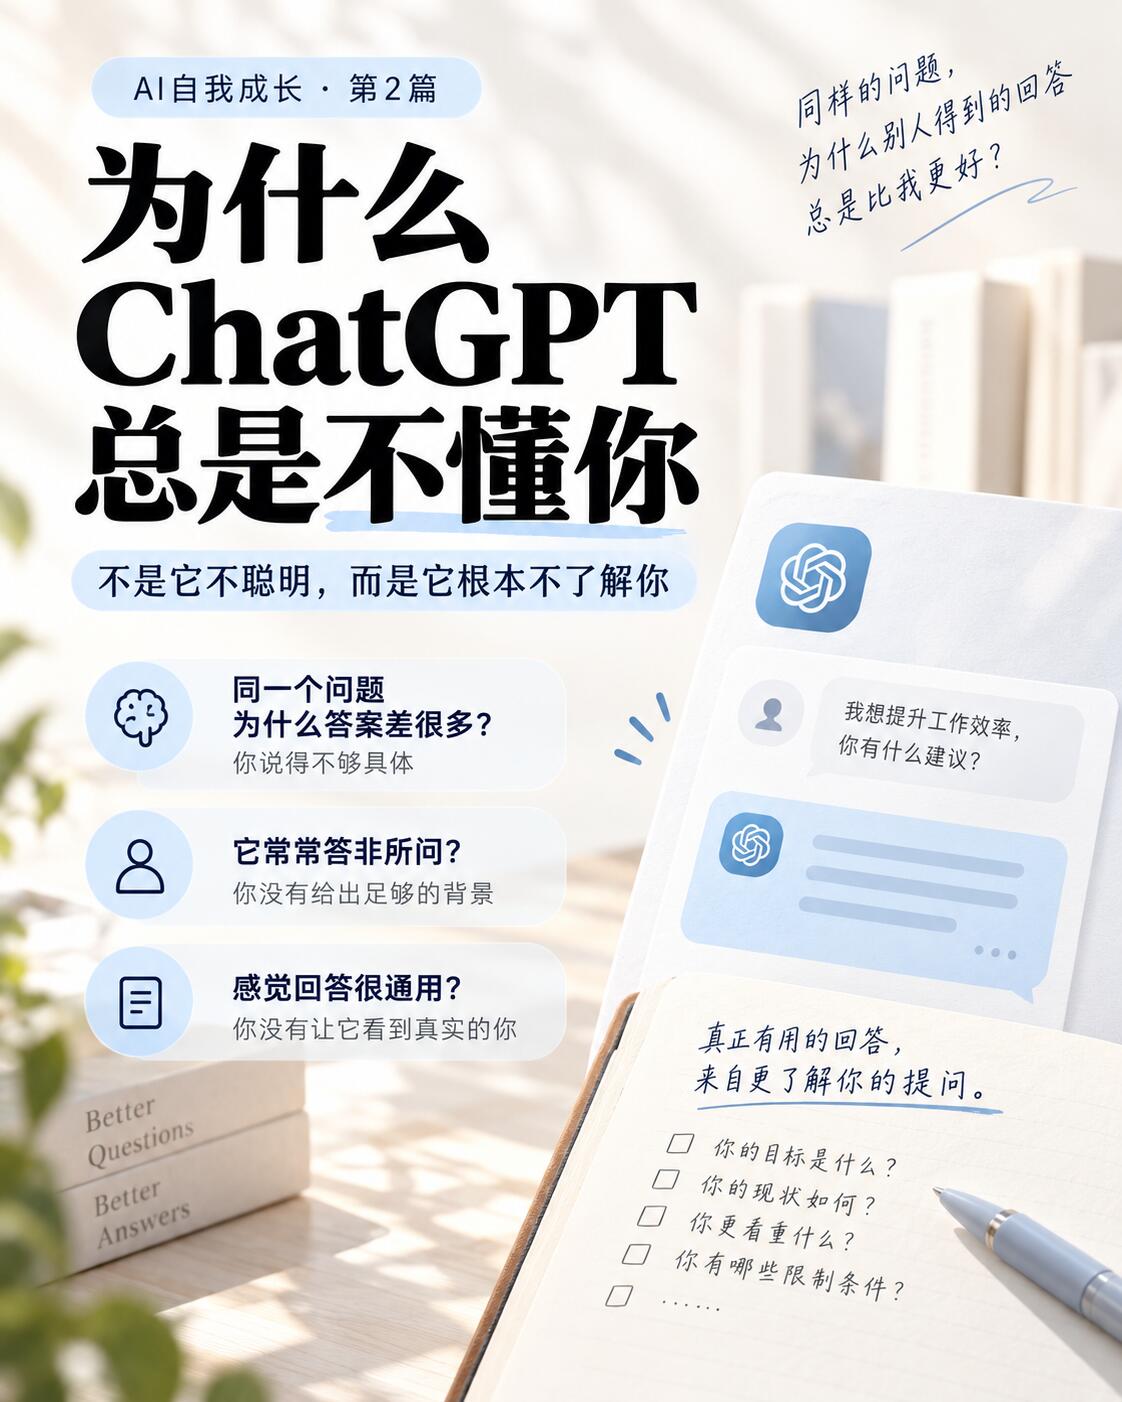
#### 机器幻觉:一本正经的“胡说八道”
ChatGPT最受诟病,也是最具迷惑性的缺陷,莫过于“机器幻觉”。这并非指它像人类一样产生视觉或听觉上的错觉,而是指模型会生成看似逻辑通顺、语气自信,实则完全虚构或与事实严重不符的内容。
这种现象的根源在于大语言模型的底层逻辑——“预测下一个字”。ChatGPT本质上是在进行一场极高维度的文字接龙游戏,它根据海量的训练数据计算词语出现的概率,而非真正“理解”世界的真理。因此,当面对它知识盲区的问题时,它不会像人类专家那样承认“我不知道”,而是倾向于根据其语言模型“编造”一个看似合理的答案。
例如,它可能会煞有介事地为你引用一篇根本不存在的学术论文,或者将民间传说当作正史来讲述。这种“一本正经的胡说八道”极具欺骗性,因为它的表达方式往往非常专业且流畅。对于依赖其进行学术研究、法律咨询或医疗建议的用户来说,这种幻觉可能导致严重的后果,如合同条款无效或错误的诊断方向。因此,将ChatGPT视为“助理”而非“真理”,对其输出的关键事实进行二次核实,是使用该系统的铁律。
#### 知识的边界:时效滞后与计算短板
尽管ChatGPT拥有庞大的知识库,但这个知识库是有“保质期”的。基础大模型的知识截止于其训练数据结束的那一刻。这意味着,对于训练截止日期之后发生的重大新闻、科技突破或社会事件,基础版ChatGPT往往一无所知。虽然目前通过联网搜索插件可以在一定程度上弥补这一缺陷,但这已属于应用层面的功能,而非模型本身的参数记忆。
此外,ChatGPT在处理需要精确逻辑和数学计算的特定工具能力上表现欠佳。虽然它能写出复杂的代码,但在处理具体的算术题或逻辑陷阱题时,却经常出现“粗心大意”的错误。这是因为它缺乏内置的计算器或逻辑引擎,其数学能力依然是基于语言模式的“猜测”,而非基于符号逻辑的“运算”。
还有一个常被误解的点是“记忆”。ChatGPT并没有人类那样的长期记忆。我们在对话中感受到的“上下文理解”,实际上是系统将之前的对话历史不断拼接、重新输入给模型的结果。随着对话轮数的增加,这种拼接的文本长度会逼近模型的上下文窗口限制,导致模型开始“遗忘”最早期的信息,或者因处理过长的文本而出现中间部分的注意力丢失。
#### 输入敏感性与安全性挑战
ChatGPT的输出质量对输入的措辞极其敏感。同样的问题,换一种问法,可能会得到截然不同的答案。这种不稳定性要求用户必须掌握一定的“提示词工程”技巧,才能引导模型输出切中要害的内容。同时,为了符合人类反馈强化学习的标准,模型有时会倾向于输出冗长、车轱辘话式的回答,显得不够简明扼要。
更为严峻的挑战在于安全性与伦理。尽管开发者设置了护栏,但ChatGPT仍可能无法完全避免对有害请求作出答复,或者被“越狱”指令诱导输出偏见、歧视甚至危险的信息(如制作危险品的教程)。此外,由于服务器架构和数据管辖的原因,其在数据隐私和跨境传输上也面临着复杂的合规性挑战。
综上所述,ChatGPT无疑是人工智能发展史上的里程碑,但它绝非完美的终极形态。它像是一个博学但偶尔会撒谎、计算能力不强且记忆力有限的“偏科天才”。只有客观认识到这些局限性,我们才能在人机协作中保持人类的主体性,既利用其效率,又规避其风险。
- 上一篇:从专家中关村看科技产业投资逻辑
- 下一篇:实测体验:AIGC赛道到底有多强?
相关文章
-
ChatGPT详解如何赋能千行百业?
11-20
-
从ChatGPT解读看人工智能的能力边界
11-19
-
ChatGPT解析对比评测,各有哪些优势?
11-18
-
ChatGPT观察训练与推理成本深度分析
11-17
-
ChatGPT行业最新版本发布,性能大幅提升
11-16