ChatGPT报告训练与推理成本深度分析
2026-11-02
浏览量:次
ChatGPT 训练与推理成本深度分析
核心结论一句话:训练是一次性资本投入、高算力高利用率;推理是随用户量线性增长的可变运营成本,规模化后推理总支出会远超训练成本阿里云开发...。说明:OpenAI
从未公开官方精确账单,下文均为行业权威测算、公开 API 定价与工程拆解,GPT-3.5(初代 ChatGPT 底座)、GPT-4 分开说明。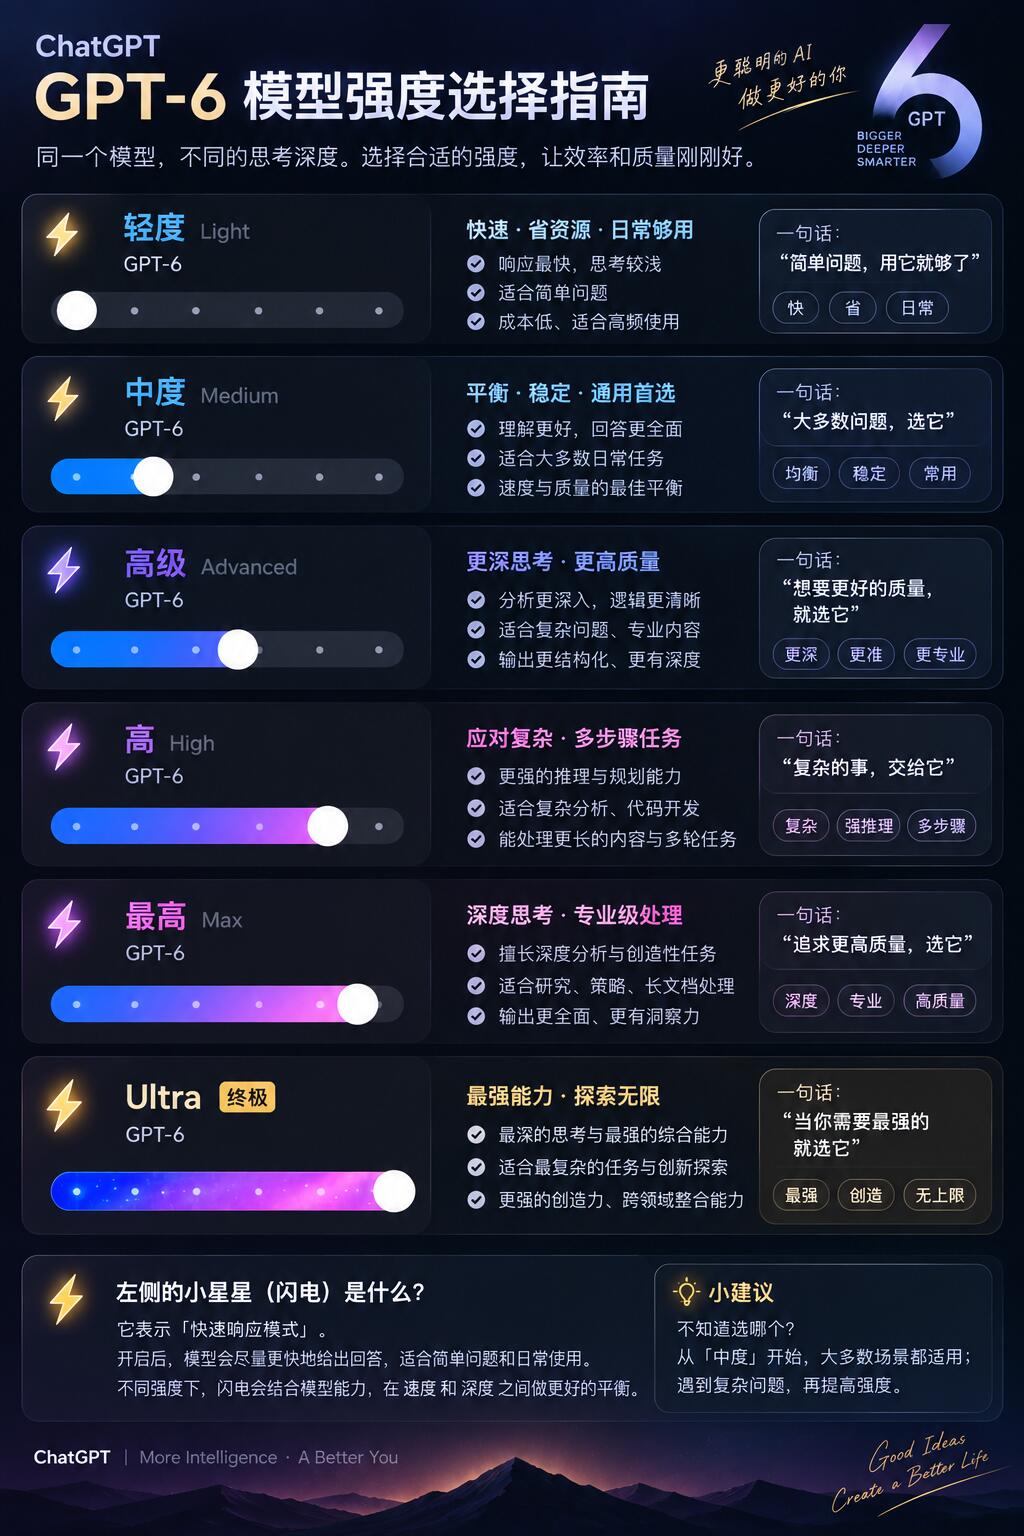
一、底层原理差异:算力、计算路径完全不同
1)训练(Training)
计算路径:前向传播 + 反向传播 + 梯度更新 + 优化器状态,每个 token 浮点运算量大约是推理的 3 倍左右
模式:大批量(Large Batch)、高度并行,GPU 利用率可以做到 60%–85%,适合超大集群长时间连续跑
工作目标:在海量文本语料上拟合权重,产出一套固定模型参数;训练跑完,权重固化
财务属性:CAPEX 资本性支出,一次性投入,分摊到模型全生命周期所有请求里
2)推理(Inference)
计算路径:仅前向传播,无梯度回传;分为 Prefill(一次性处理输入上下文)+ Decode(逐 token 串行生成输出)
模式:小批量、高并发、长短不一的用户请求;Decode 阶段是显存带宽瓶颈,天然并行度低,原生 GPU 利用率通常只有 15%–35%,靠 KV Cache、连续批处理提升
工作目标:接收用户 prompt,实时生成回答;每一条对话都要重新消耗算力
财务属性:OPEX 运营可变成本,用户越多、对话越长、输出越多,账单越高
关键行业共识:上线稳定运营后,推理通常占到整体算力支出 60%–80%,GPT-4 在大规模流量下,短短数月推理累计成本就超过训练总成本。
二、训练成本拆解(GPT-3.5 / GPT-4)
1)GPT-3.5-turbo(ChatGPT 初代底座,175B 参数 GPT-3 衍生微调)
行业主流测算区间:纯预训练算力成本约 150–200 万美元(云算力报价口径);自建集群可压到 50 万上下
这个数字只算主预训练算力,不含下面隐性成本:
数据成本:高质量清洗、去重、过滤、版权、人工标注(RLHF 人类反馈强化学习是一笔大头)
实验成本:上百次小实验、超参搜索、失败试跑,很多项目跑废
人力成本:算法、分布式、数据、集群运维团队
机房、供电散热、网络、存储、折旧
RLHF(对齐训练)成本:远小于主预训练,但不可忽略;对齐阶段算力需求低、标注人力贵。
2)GPT-4
Epoch、多家投行测算:GPT-4 主预训练算力成本大约 7000 万–1 亿美元区间,有版本估算接近 7900 万美元算力成本,同样不含数据、标注、研发试错。 GPT-4 是 MoE 混合专家架构,不是稠密大模型;它激活参数远小于总参数,改变了训练算力曲线,但调度、通信、负载均衡的工程成本显著上升。
训练成本构成占比参考(稠密大模型)
GPU 算力租赁 / 硬件折旧:65%–75%(最大头)
电力 + 机房 PUE:10%–18%
数据集采购、清洗、标注:5%–12%
研发人力、集群运维:5%–10%
存储、高速网络、故障冗余:剩余部分
训练成本的最大变量:GPU 利用率。几千卡集群分布式通信开销巨大,一旦利用率掉下来,单位成本直接飙升。
三、推理成本拆解(最容易被低估的部分)
推理成本 = Prefill 成本 + Decode 成本 + 配套开销,输出 token 成本显著高于输入 token,这也是 OpenAI API 定价规则:输出单价 > 输入单价OpenAI。
1)公开 API 定价参考(OpenAI 官方,按百万 token 计价)
GPT-3.5-turbo(低成本版本):输入远低于输出,适合大批量问答
GPT-4o:输入 $2.5 / 1M token,输出 $10 / 1M token(典型区间)
缓存 KV 上下文:OpenAI 单独给缓存 token 折扣价,长对话、多轮会话场景可以大幅降本OpenAI
定价≠底层硬件成本,API 售价包含:硬件折旧、电力、集群调度、冗余、带宽、客服、利润、风险溢价。硬件原生推理成本远低于对外售价。
2)推理内部成本分项
显存带宽(Decode 瓶颈):每生成一个新 token,都要反复读取模型权重 + KV 缓存;模型越大、上下文越长,显存压力越大,这是推理最核心约束
KV 缓存开销:多轮对话、长文档(128K 上下文),KV 缓存占用显存随序列长度平方增长;长上下文场景成本会非线性上涨
批处理效率:连续批处理、动态 batching 是提升利用率核心;用户请求随机涌入,尖峰流量必须预留冗余算力,低峰期 GPU 空转抬高平均成本
隐性推理成本(业务侧经常漏掉)
重试成本:模型输出不符合预期、超时、报错重试,token 翻倍消耗
Agent 智能体:工具调用、多轮思考、循环自查,token 消耗是普通问答数倍
后处理、安全审核、内容过滤、日志、监控带宽
排队延迟 SLA 保障:为保证首 token 速度,不能把 GPU 打满,预留算力冗余
3)场景对比(同样 token 数,成本差异巨大)
短问答(100 输入 + 150 输出):输出占主要成本
长文档摘要(10 万输入、短输出):Prefill 成本为主,KV 缓存折扣价值很高
Agent / 代码编写:大量思考、迭代、工具返回,输出 token 占比极高,单价最贵
四、训练 vs 推理:关键对比表
表格
维度训练推理
计算前向 + 反向 + 梯度更新仅前向
FLOPs / Token高(≈3 倍推理)低
GPU 利用率高 60%–85%低 15%–35%(优化后可到 40–50%)
算力瓶颈算力(TFLOPS)显存带宽 HBM
成本模式一次性、CAPEX随流量线性增长、OPEX
规模效应规模越大,单卡摊薄越好规模大了可以提升批处理,但流量上涨直接加账单
优化方向分布式并行、混合精度、ZeRO、MoEKV Cache、PagedAttention、量化、 speculative decoding、缓存、批调度
五、行业降本路线(训练侧 & 推理侧)
训练降本
MoE 混合专家:每次只激活一部分参数,降低每步计算量(GPT-4 路线)
更好的数据过滤:高质量数据减少无效训练步数,比堆卡更划算
混合精度 FP8、低精度优化器、梯度检查点
自建算力中心,锁定长期电价,避开公有云溢价
推理降本(现在行业主战场)
KV 缓存优化:PagedAttention、KV 量化、KV 复用、上下文缓存(OpenAI 缓存定价就是这个逻辑)
模型量化:FP8、INT4,权重压缩,降低显存占用,单卡承载更多并发
投机解码(Speculative Decoding):小模型草稿 + 大模型校验,减少大模型解码步数
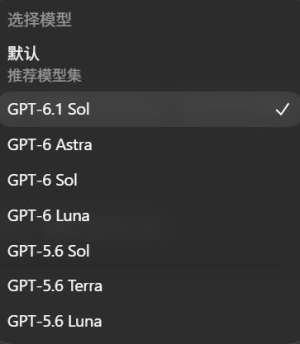
路由分流:简单请求走小模型(Luna/Terra 这类轻量版),复杂任务才上旗舰
Prompt 工程、上下文裁剪、输出长度限制,减少无效 token 生成
离线预计算、检索增强 RAG,减少把全部文档塞进上下文
六、商业模型测算示例(便于理解量级)
假设一个产品:每日 100 万次对话,平均每次 300 输入 token、300 输出 token,用 GPT-4o:
日输入 token:3 亿;日输出 token:3 亿
按 $2.5 / 1M 输入、$10 /1M 输出:
输入日成本:750 美元
输出日成本:3000 美元
合计每日推理成本:3750 美元,月超 11 万美元对比 GPT-4 训练算力成本约 7900 万美元:在这个流量规模下,大约不到 20 个月推理总支出就追上训练算力投入;如果流量继续上涨,这个时间会大幅缩短。
七、常见误区澄清
❌ 误区:训练最贵,推理不值一提 ✅ 正解:训练是一次性巨款;只要用户规模起来,推理是持续滚雪球的账单,长期更大。
❌ 误区:token 价格就是 GPU 硬件成本 ✅ 正解:API 标价包含大量冗余、SLA、利润、安全成本;裸硬件推理成本远低于售价。
❌ 误区:长上下文只是多一点 token,线性涨价 ✅ 正解:Prefill 注意力计算是 O (n²),上下文拉长,成本非线性上升,KV 缓存才是长对话的核心开销。
❌ 误区:模型压缩只影响推理 ✅ 正解:蒸馏、量化很多是在训练 / 后训练阶段完成,属于为推理服务的前置投入。
八、趋势总结
前沿模型训练成本增速放缓,行业重心从 “堆算力训更大模型” 转向推理效率优化;
Agent 智能体浪潮会显著抬升推理成本,因为它不再是一问一答,而是多轮思考 + 工具调用循环;
分层模型体系成为标准:轻量模型承接绝大多数日常请求,旗舰模型只处理高价值复杂任务,控制整体推理 TCO;
缓存、HBM、专用推理芯片、解码算法是接下来几年降本主线。
- 上一篇:从PE看科技产业投资逻辑
- 下一篇:零基础上手AIGC现状,快速入门教程
相关文章
-
ChatGPT详解如何赋能千行百业?
11-20
-
从ChatGPT解读看人工智能的能力边界
11-19
-
ChatGPT解析对比评测,各有哪些优势?
11-18
-
ChatGPT观察训练与推理成本深度分析
11-17
-
ChatGPT行业最新版本发布,性能大幅提升
11-16