一文说清ChatGPT产业的技术架构
2026-10-13
浏览量:次
ChatGPT产业技术架构:从底层算力到应用入口的全景图
ChatGPT不是单一模型,而是一条“算力—模型—平台—应用”协同运转的产业链。它的技术架构可以分成六层:数据与能源层、芯片与硬件层、算力与云基础设施层、模型与对齐层、平台与工具层、应用与入口层。越往下游,越接近用户;越往上游,越决定成本、效率和商业议价权。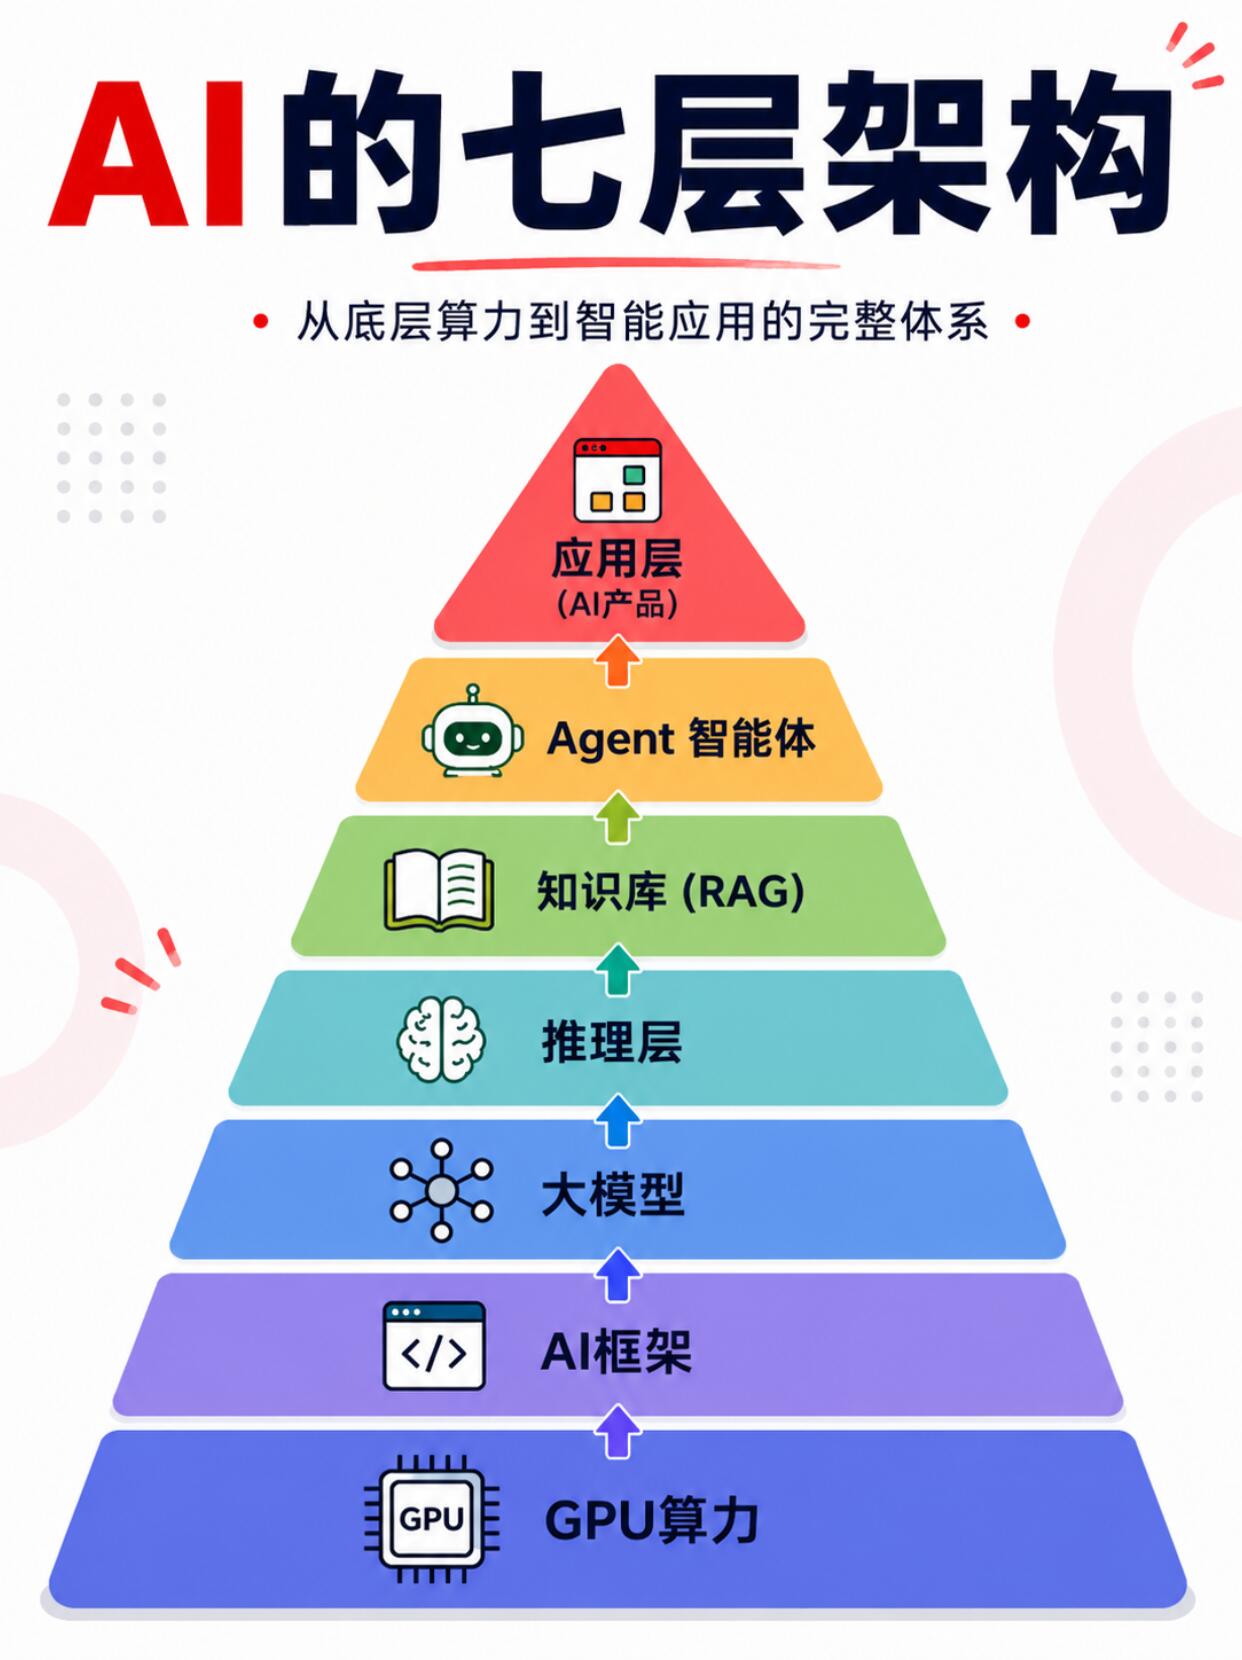
1. 数据与能源层:AI的“燃料”和“电力”
大模型首先要“吃”数据,也要消耗大量电力。数据层负责采集、清洗、标注、合成和合规管理,决定模型能学到什么;能源层则提供数据中心所需的电力、散热、机柜和网络环境。
这一层看似不直接面向用户,但会直接影响训练成本、推理延迟和模型质量。随着模型规模扩大,电力、散热、数据中心容量正在成为AI产业的重要瓶颈。
2. 芯片与硬件层:决定算力供给
这一层主要包括 GPU/ASIC 芯片、HBM 高带宽内存、光模块、交换机、服务器、先进封装和存储系统。GPU 是当前训练和推理的核心算力载体,HBM 决定数据吞吐速度,光模块和高速网络决定多卡、多机协同效率。
在产业逻辑上,这一层属于典型的“卖铲子”环节:无论哪家模型最终胜出,只要大模型训练和推理需求增长,芯片、服务器、光模块、存储和封装都会受益。
3. 算力与云基础设施层:把硬件变成可用算力
这一层包括 智算中心、云计算平台、容器集群、分布式存储和高速网络。OpenAI 等模型厂商并不直接拥有全部硬件,而是通过云服务商获得大规模 GPU 集群。
典型架构会采用容器化部署、Kubernetes 调度、分布式训练和弹性推理服务。企业级系统还会加入 API 网关、负载均衡、缓存、监控告警和安全隔离,以保证高并发下的稳定性和成本可控。
4. 模型与对齐层:ChatGPT的“大脑”
ChatGPT 的核心模型基于 Transformer Decoder-only 架构,采用自回归方式预测下一个 Token。它的关键技术环节包括:
预训练:在大规模文本、代码和多模态数据上学习语言规律和世界知识。
监督微调:让人工标注数据教会模型更好地遵循指令。
RLHF 对齐:通过人类反馈强化学习,让输出更安全、更有用、更符合人类偏好。
MoE 混合专家:在部分新版本中引入动态路由,只激活部分专家网络,降低推理成本。
多模态与 Agent 能力:从文本扩展到图像、音频、视频,并逐步具备规划、工具调用和任务执行能力。
从 GPT-4 到 GPT-5 系列,模型架构已经从“会聊天”转向“会执行”。GPT-5.4 引入了统一路由、推理时计算缩放、百万级上下文和原生计算机操作能力;GPT-5.5 进一步强化了 Agent 智能体能力。
5. 平台与工具层:把模型变成可开发能力
这一层负责把底层模型封装成开发者可用的服务,典型组件包括:
API 服务:提供文本、对话、嵌入、图像、音频等接口。
向量数据库:存储企业文档、知识库和产品资料,支撑语义检索。
RAG 检索增强:让模型结合外部知识回答,提高准确性和时效性。
Agent 与工作流编排:让模型调用工具、执行多步骤任务。
Prompt 工程与安全过滤:控制输出质量、合规性和业务边界。
这一层是“模型能力”到“业务价值”的转换器。企业真正关心的往往不是模型参数有多大,而是能否接入现有系统、能否稳定响应、能否降低人工成本。
6. 应用与入口层:用户真正接触到的产品
最外层包括 ChatGPT 网页端、移动端、插件、企业应用、行业解决方案和智能体入口。常见落地场景有:
智能客服
内容生成
代码辅助
数据分析
知识问答
办公自动化
行业垂类应用
未来入口竞争会越来越重要。谁能把模型能力嵌入工作流、操作系统、浏览器、终端设备或企业系统,谁就更可能掌握用户触达和流量分配。
产业价值分配:上游更稳,下游看场景
相关文章
-
ChatGPT式如何赋能千行百业?
10-28
-
ChatGPT应用最新版本发布,性能大幅提升
10-27
-
ChatGPT平台最新版本发布,性能大幅提升
10-26
-
ChatGPT市场的局限性在哪里?客观解读
10-24
-
ChatGPT展望训练与推理成本深度分析
10-23