从ChatGPT看人工智能的能力边界(深度解析)
2026-10-12
浏览量:次
从ChatGPT看人工智能的能力边界
核心摘要:ChatGPT代表当前大语言模型(LLM)的能力高点,它擅长基于海量文本的概率式生成、知识整合、语言翻译、逻辑推理、内容创作;但其本质是预测下一个token的统计模型,不具备真正的感知、意识、主观理解与自主意图。从ChatGPT的表现可以清晰看到:当前AI的优势来自对人类已有知识的拟合,而能力边界根植于模型底层原理,集中体现在事实幻觉、因果缺陷、真实世界认知缺失、自主目标能力不足等方面。它是强大的“语言模拟器”,而非具备自我认知的通用人工智能(AGI)。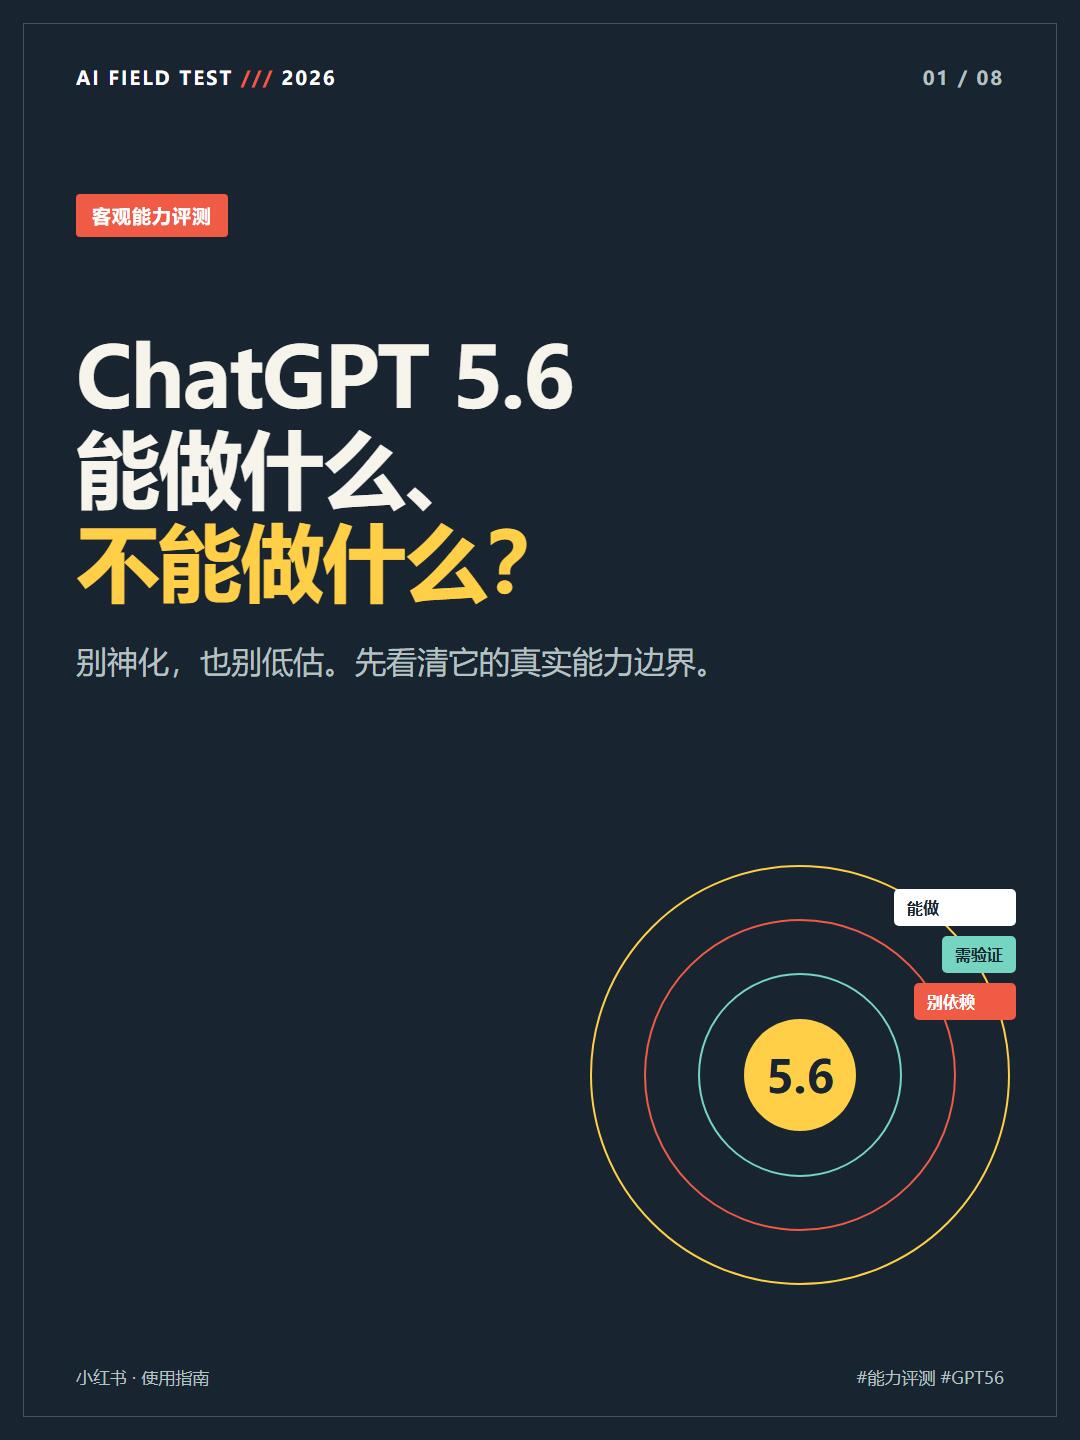
一、ChatGPT核心能力:能做到什么
ChatGPT系列大模型的核心能力,全部建立在大规模文本预训练+对齐微调(RLHF/SFT)之上:
自然语言理解与生成:流畅对话、文案写作、摘要翻译、润色、结构化输出,适配各类文本任务;可跨语言、跨文体完成复杂文字工作。
符号推理与问题拆解:基础数学运算、代码编写调试、逻辑论证、方案拆解,能够分步完成多步骤推理任务。
知识检索与整合归纳:整合海量公开文本信息,对概念、案例、理论做归纳总结,输出体系化知识。
任务对齐与指令跟随:通过人类对齐,理解用户意图,按照要求调整输出风格、格式,完成定制化任务。
多模态扩展(GPT-4V):识别图片中的文字、图表、简单物体,完成图文联动分析,拓展纯文本之外的信息输入。
一句话概括:擅长处理符号与语言层面的任务,擅长模仿人类的表达与推理形式。
二、从ChatGPT看AI的四大底层能力边界
边界1:没有真正理解,只有概率拟合,存在“幻觉”固有缺陷
模型并不“懂”文字含义。它学习的是海量文本里词语、句子之间的统计关联,根据上文概率预测下一个词。
直接后果就是AI幻觉:会编造不存在文献、案例、法条、数据,输出看起来逻辑通顺但完全虚假的内容。哪怕是专业领域,也可能一本正经输出错误结论。
关键特征:AI无法区分“自己知道”和“自己猜测”,没有内在的认知置信判断。它只会生成通顺文本,不会像人一样感知“我不确定”。加入检索工具(RAG)可以缓解幻觉,但无法彻底根除。
边界2:因果推理薄弱,擅长相关性,不擅长真实因果
ChatGPT可以做形式逻辑、演绎推理,但很难稳定完成真实世界因果判断。它学习的是文本里的共现关系,而非真实物理、社会世界的因果机制。
典型现象:遇到反常识、新场景、违背日常物理规则的问题时容易出错;容易混淆相关关系和因果关系;面对全新的、训练数据里极少出现的复杂场景,推理会快速失效。
人类可以基于底层机理推导未知场景;大模型更多是类比已有案例,案例缺失,推理就容易崩塌。
边界3:缺乏物理世界具身感知,没有真实体验
ChatGPT训练数据是文本、图片等静态信息,没有实体感官,没有在现实世界中触摸、观察、试错的体验,属于“脱离物理世界的纯符号智能”。
它知道“水会流动”是因为文本描述,而不是亲身感知。面对大量现实世界隐性常识、空间直觉、动态物理交互任务,容易出现低级错误。
这也是为什么:大模型做纸上推演很强,但直接操控机器人、处理真实环境动态变化的任务,难度极高。纯语言模型缺少现实世界的 grounded(接地)认知。
边界4:无自主意识、主观意图、真实欲望,目标依赖人类设定
ChatGPT没有自我,没有喜怒哀乐,没有内生目标。它不会主动产生想法、不会自发追求某个长期目标,所有任务都来自人类的指令。
它的“偏好”是对齐训练的结果,不是内生价值观。当目标模糊、存在多目标冲突时,容易出现目标错位、对齐溢出。它不会主动思考“我为什么要做这件事”,只会按指令生成回答。
这也是区分当前大模型与AGI的核心标志:没有自主主体性。
三、其他现实层面边界(工程与应用边界)
时效性边界:基础模型存在训练截止时间,天然不知道截止之后发生的新事件;联网插件可以获取实时信息,但存在检索误差。
长上下文边界:虽然支持超长上下文窗口,但超长文本中容易丢失远端细节,出现“遗忘”,信息密度越高,越容易出现关键信息遗漏。
算力与成本边界:复杂推理、长文本、多模态推理消耗大量算力,推理成本、响应延迟构成商业化约束,无法无限低成本运行。
价值与安全边界:容易被提示词劫持、诱导输出有害内容;容易继承训练数据中的偏见;在高风险场景(医疗诊断、司法判决、重大工程决策)不能直接替代专业人员。
创造性边界:AI的“创作”是对已有作品重组、插值、变换,不是人类那种源于生命体验的原创。可以产出新颖组合,但很难诞生完全脱离已有范式的颠覆性原创。
四、容易混淆的认知误区
❌误区1:对话流畅=拥有理解能力。流畅只是语言统计拟合,不是真正理解。
❌误区2:能解决难题=拥有通用智能。它擅长在训练分布内完成任务,一旦超出训练分布,性能断崖式下跌。
❌误区3:模型规模无限变大就能实现AGI。规模提升可以改善部分能力,但无法直接补齐意识、具身感知、真实因果等底层缺陷。
五、启示:AI能力边界带来的产业与应用定位
1. 定位:超强协作助手,而非决策者。适合做信息汇总、初稿生成、方案推演、代码辅助、知识问答;高风险决策必须由人复核,AI输出必须核验事实。
2. 能力增强路径:模型+工具。单纯扩大模型参数收益递减,接入检索、计算器、代码解释器、传感器、机器人等外部工具,弥补模型本身的短板(RAG、Agent),是当前突破应用边界的主流方式。
3. 人机分工重塑:AI擅长符号化、重复性、信息整合类工作;人类负责价值判断、因果溯源、创新突破、承担最终责任。
六、总结
ChatGPT证明:大规模语言模型可以实现极为强大的语言、推理、创作能力,在大量知识性、文本类任务上达到甚至超越普通人。但它的底层原理决定了不可逾越的能力边界:没有真实理解,没有意识,缺少现实世界体验,因果认知不稳定,容易产生事实幻觉。
当前大模型属于专用人工智能(弱AI),不是通用人工智能。未来AI发展,不是单纯追求模型更大,而是通过工具、具身、多模态、对齐技术,拓展适用场景;但模型本身的底层认知缺陷,短期内无法彻底消除。认识这一边界,是合理使用AI、管控AI风险的前提。
相关文章
-
ChatGPT式如何赋能千行百业?
10-28
-
ChatGPT应用最新版本发布,性能大幅提升
10-27
-
ChatGPT平台最新版本发布,性能大幅提升
10-26
-
ChatGPT市场的局限性在哪里?客观解读
10-24
-
ChatGPT展望训练与推理成本深度分析
10-23