一文说清CPU推理的技术架构
2026-09-17
浏览量:次
CPU推理在2026年已从"GPU的降级备选"转变为AI推理时代的独立主力路径,核心逻辑是"推理≠训练"——推理阶段更关注延迟、成本与部署效率,而非极致并行算力。 截至2026年9月,随着AI智能体(Agent)兴起,CPU推理正在中小模型、边缘部署、Agent调度等场景迎来价值重估。
为什么CPU推理突然重要?
1. 算力结构转型:从训练到推理
训练阶段:GPU是绝对主力,CPU仅承担数据搬运+集群调度(占比10-30%)
推理阶段:CPU依赖度普遍超60%,部分场景达100%(请求处理、数据清洗、KV Cache调度、检索路由等)
Agent时代:多智能体调度、工具调用、沙箱执行、长上下文管理均为CPU密集型负载,CPU:GPU配比从1:8向1:4乃至1:1演进
2. 量化技术突破
INT4/INT8量化使7B模型内存占用从14GB降至4-5GB,让CPU推理在16GB内存设备上成为可能
第五代至强运行200亿参数以下LLM时,词元处理时延可低于100ms
3. 硬件架构进化
Intel AMX指令集:支持BF16/INT8矩阵运算,第五代至强AI推理性能较第四代提升42%
ARM SVE/SME:Graviton4内存带宽达537.6GB/s,较Graviton3提升75%
大L3缓存:AMD 7800X3D的96MB总缓存显著降低KV Cache访问延迟
CPU vs GPU 推理性能对比
表格
下载为表格
导出为图片
维度CPU推理GPU推理
核心优势低延迟响应、复杂逻辑控制、内存容量大高吞吐并行、矩阵运算密度高
内存带宽DDR5约30-537GB/sHBM3约4-8TB/s
Prefill阶段较慢(GPU快3-4倍)极快
Decode阶段至强6+AMX下7B模型可达18-25 token/s,与单张A100差距缩小至15%以内极快,但Decode阶段GPU算力闲置率高
成本起建成本降低50%以上,单位Token成本为GPU的1/8-1/12硬件昂贵,一卡难求
适用模型3B-13B量化模型(甜点区间),72B可运行但速度受限全尺寸模型,70B+唯一商用解
实测数据参考
3B INT8模型:CPU推理速度80-100 tokens/sec,与GPU接近
7B模型:阿里云g8i实例首包时延<1秒,生成速度12 Tokens/s
70B模型:96 vCPU配置下首包时延1-3秒,生成速度7 Tokens/s;Graviton4可达10-60 t/s
13B INT8模型:GPU推理速度是CPU的30倍,单Token成本降低50%以上
CPU推理适用场景
强烈推荐CPU的场景
中小模型私有化部署:6B-13B模型起建成本较GPU降低50%以上,适合企业内部知识库、客服机器人
边缘设备与IoT:无GPU环境下的降级方案,如车载、工控机、智能摄像头
Agent任务调度:工具调用、沙箱执行、多智能体编排天然依赖CPU架构
RAG向量检索:向量数据库索引与搜索主力算力在CPU,Intel 96核Xeon在亿级向量检索上比AMD快2.71-7.34倍
隐私合规场景:利用CPU内置SGX/TDX机密计算技术,满足医疗、金融数据合规
低频高延迟敏感任务:小吞吐但要求毫秒级响应的实时交互
不推荐CPU的场景
70B+大模型高并发服务:CPU推理速度不足10 tokens/sec,无商用价值
批量图像处理/视频生成:GPU并行优势碾压,A100比Xeon Gold快16倍以上
训练阶段:GPU能效比是CPU的5-8倍
CPU推理优化策略
1. 量化是前提
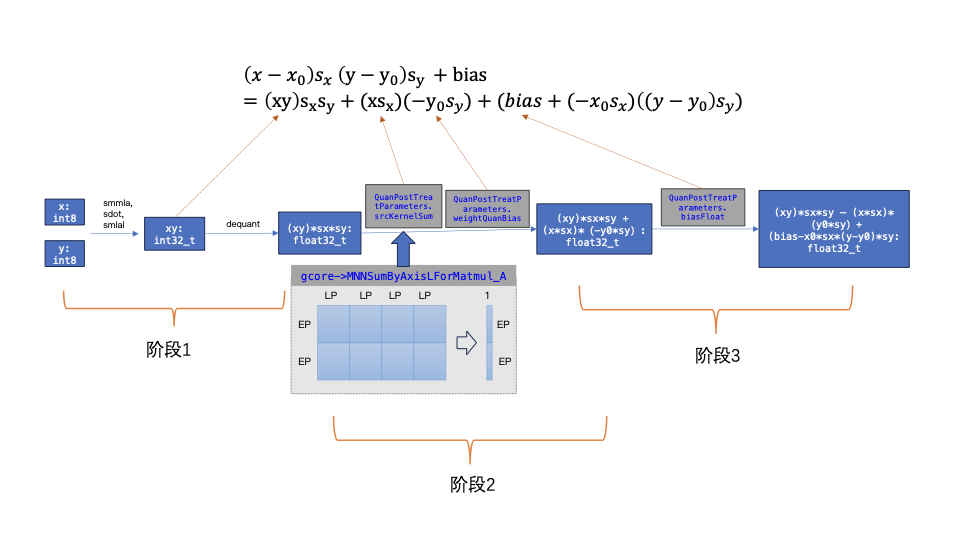
INT8量化依托AVX-512 VNNI指令,推理吞吐量较FP32提升4倍
INT4量化依赖AMX原生mpGEMM运算,可将7B/13B模型延迟控制在100ms以内
2. 框架选型
llama.cpp + GGML/GGUF:纯CPU推理首选,配合OpenBLAS及mmap加载可提速约50%
OpenVINO:较原生PyTorch延迟降低50%,Intel硬件深度优化
ONNX Runtime + XNNPACK:轻量级模型CPU推理的高效后端
ms-swift:支持BF16/FP16半精度加载、KV Cache复用、分块加载防OOM
3. 系统调优
线程数:配置为物理核心数×(1~1.5),避免超过逻辑核心数
CPU亲和性:绑定进程到特定核心,减少上下文切换
关闭超线程:在vLLM多实例或OpenVINO场景中可显著提升效率
NUMA-aware内存分配:避免跨NUMA节点访问延迟
4. 协同推理(CPU+GPU混合)
层间分割(Layer-wise Offloading):通过-ngl参数控制GPU层数,剩余层卸载至CPU解决显存不足
KV Cache卸载:GPU显存超阈值时,将历史KV Cache移至CPU内存
LIA协同框架:CPU分担中低层解码及KV Cache存储,70B模型协同推理吞吐量提升5.1倍
硬件选型建议(2026年)
表格
下载为表格
导出为图片
定位推荐型号关键特性
旗舰推理Intel酷睿i9 14900K / Ultra 9 285K24线程/36MB缓存/AVX-512/PCIe 5.0
高性价比Intel i5 14600KF / AMD 7800X3D96MB总缓存适合序列推理/RAG
服务器Intel Xeon 6900P系列 / 至强6+AMX指令集/192核/DDR5
ARM云实例AWS Graviton4 / Google Axion能效比x86提升60%/内存带宽537GB/s
RISC-V新势力阿里玄铁C950SPECint2006超70分,原生支持Qwen3/DeepSeek V3
趋势判断
CPU推理不会取代GPU,但会成为推理架构的"必要一极":在Agent、RAG、边缘、中小模型场景形成独立生态
CPU:GPU配比持续收敛:BofA预测2025-2030年服务器CPU市场规模从266亿增至1252亿美元,CAGR约36%
x86与ARM双轨并行:x86凭生态优势在云上占主导,ARM凭能效在端侧/Agent场景渗透率将提升至44%
纯CPU集群已验证可行性:灵晟超算LX2 CPU集群16节点在batch_size=2048下吞吐量与80张主流GPU相当
- 上一篇:AI竞赛最新动态,行业格局生变
- 下一篇:AIGC发展工具推荐与使用技巧