从CLIP看人工智能的能力边界
2026-09-17
浏览量:次
CLIP(Contrastive Language-Image Pre-training,对比语言-图像预训练)是 OpenAI 于 2021 年发布的多模态神经网络模型,核心突破在于通过自然语言监督实现图像与文本的语义对齐,具备强大的零样本(Zero-Shot)迁移能力。
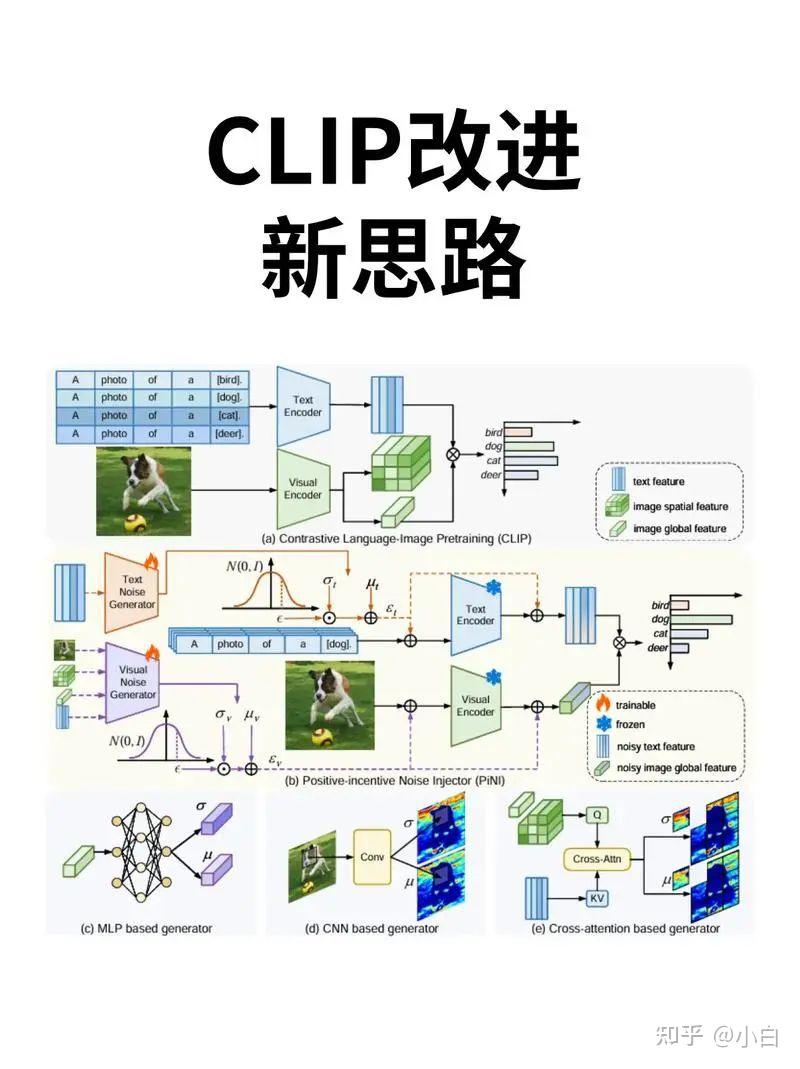
核心架构:双塔对比学习
CLIP 采用双编码器架构,将图像和文本映射到同一个高维嵌入空间(通常为 512 维或 1024 维):
表格
下载为表格
导出为图片
组件架构选择功能
图像编码器ResNet 或 Vision Transformer (ViT)将图像转换为固定维度的视觉特征向量
文本编码器Transformer(类似 GPT-2)将文本转换为同维度的文本特征向量
训练原理:在约 4 亿对互联网图文数据上,采用对比学习范式。每个 batch 内构建 N×N 相似度矩阵,通过对称交叉熵损失函数(InfoNCE Loss)最大化匹配图文对的相似度、最小化非匹配对的相似度。
三大核心能力
零样本分类:无需微调,直接将类别名转换为文本提示(如 "a photo of a {class}"),通过计算图像与文本特征的余弦相似度完成分类。ViT-L/14 架构在 ImageNet 零样本测试准确率达 76.2%。
跨模态检索:支持"以文搜图"和"以图搜文"的双向检索,在共享嵌入空间中通过余弦相似度匹配。
语义理解:能理解复杂场景与抽象描述,将视觉概念与自然语言直接映射。
关键应用场景
AIGC 文本引导:作为 Stable Diffusion、DALL·E 等生成模型的条件输入,评估生成图像是否符合文本描述
图像自动标注与内容审核:自动识别暴力、裸露等违规内容,大幅降低人工审核成本
电商视觉搜索:理解材质、颜色、风格等抽象属性,实现更精准的以图搜图
医疗影像分析:作为预训练范式用于医学图像分类、报告生成等临床任务
多模态大模型底座:Flamingo、LLaVa 等视觉语言模型均使用 CLIP 作为图像编码器
局限性
细粒度理解不足:不擅长计数、抽象关系判断及细粒度分类(2026 年 360 开源的 FG-CLIP2 正致力于攻克此难题)
文本长度受限:处理上限为 77 个 token,长文本理解能力有限
数据偏见:训练数据来自互联网,在性别、种族等维度存在刻板印象风险
官方声明:不推荐用于监控、人脸识别及非英语场景的未测试部署
生态衍生
截至 2023 年已衍生出 OpenCLIP(社区开源实现)、ChineseCLIP(中文优化版)等项目;2026 年同济大学团队提出 LLM2CLIP,通过引入大语言模型能力提升长文本理解与跨语言性能。
- 上一篇:AI科技巨头产业链上下游深度剖析
- 下一篇:没有了
相关文章
-
从CLIP看人工智能的能力边界
09-17
-
从BLIP看人工智能的能力边界
09-13

-
BF16技术全解析:原理、应用与前景
08-04

-
Agent的局限性在哪里?客观解读
08-03

-
API调用的开源生态与商业路径
08-02